





nginx上游连接数打满导致代理拒绝服务,本质是无法获取可用后端连接,表现为502、no live upstreams或upstream timed out;需从系统层(ss/netstat/dmesg)、nginx配置层(keepalive/max_conns/超时)、日志线索(debug级keepalive状态、connect timeout、listen overflows)三方面交叉验证。
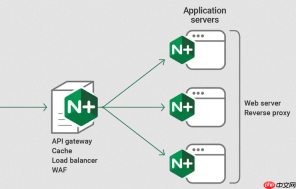
Upstream 连接数打满导致代理拒绝服务,本质是 Nginx 无法获取可用后端连接,常见表现为 502 Bad Gateway、no live upstreams 或 upstream timed out。问题不在配置“错”,而在于连接资源被无效占用或未及时释放。排查需从系统层、Nginx 配置层、日志线索三方面交叉验证。
看真实 ESTABLISHED 连接数是否超标
别只信配置里的 keepalive 32,要查实际建了多少连接:
- 用
ss -tan | grep :<em>upstream_port</em> | grep ESTAB | wc -l统计当前到每个后端的活跃 TCP 连接数 - 对比理论上限:若
worker_processes是 4,keepalive 32,则每个后端最多缓存4 × 32 = 128条空闲连接;但实际 ESTABLISHED 数若持续超过 200,说明连接没按预期回收,存在泄漏 - 特别注意
SYN_SENT状态连接大量堆积——这表示 Nginx 正在疯狂重试建连,后端 accept 队列可能已满(如net.core.somaxconn仍为默认 128)
查 error_log 里高频出现的关键错误
错误日志不是结果,而是入口线索:

-
upstream connection is busy:连接池中所有连接正被占用或处于半死状态,新请求拿不到连接 -
no live upstreams while connecting to upstream:所有节点被标记为 down,重点看是否因max_fails=1 fail_timeout=10s这类敏感设置误判 -
connect() failed (110: Connection timed out):TCP 层能通,但后端不响应 accept,可能是进程卡死、OOM 后被杀、或磁盘满导致监听失败 -
upstream prematurely closed connection:后端主动断连,常伴随连接复用异常,比如 HTTP/1.0 响应没带Connection: keep-alive却被 Nginx 错误复用
确认 keepalive 行为是否真正生效
空闲连接没被放回池子,等于没配 keepalive:
- 启用 debug 日志:
error_log /var/log/nginx/error.log debug;,搜索keepalive free和keepalive close,看是否有连接被成功归还 - 检查 upstream 块是否显式写了
keepalive_timeout 30s(默认 60s 太长),并设max_requests 100防止单连接承载过多请求后状态异常 - 确保后端返回标准 HTTP/1.1 响应头:
Connection: keep-alive,且响应体完整;若后端是 HTTP/1.0,需在 location 中加add_header Connection keep-alive; - 避免协议误判:upstream 块内明确写
type=http;,防止 Nginx 跳过 keepalive 检查逻辑
验证后端真实服务能力与资源水位
别依赖健康检查结果,动手直连才可靠:
- 用
curl -v http://IP:PORT/health测业务路径,观察是否真返回 200,还是卡住或超时 - 执行
ss -tlnp | grep :<em>port</em>,确认端口确实被你的应用进程监听;若无输出,可能是服务没启、启错端口,或 systemd 静默重启失败 - 检查后端机器基础资源:
df -h(磁盘满会导致监听失败)、free -h(内存不足触发 OOM)、dmesg -T | tail(找 OOM Killer 记录) - 运行
netstat -s | grep -i "listen overflows",若数值持续增长,说明 accept 队列长期溢出,必须调大net.core.somaxconn和后端应用的acceptCount





