





性能测试需量化nginx心跳检测对cpu、内存、连接数和延迟的额外开销,通过抓包确认探测行为,分场景压测对比启停心跳的资源差异,并验证误判风险与监控指标落地。
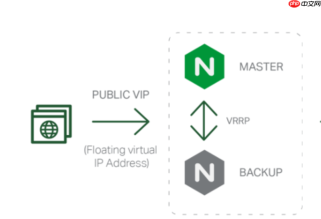
在性能测试中评估 Nginx 心跳检测对后端服务器的额外开销,核心是分离探测流量与真实业务流量,量化其 CPU、内存、连接数和响应延迟的影响。不能只看“有没有报错”,而要测它“悄悄多干了多少活”。
明确心跳请求的特征与基线对比
主动心跳(如 nginx_upstream_check_module 发起的 /healthz 探测)本质是一类轻量 HTTP 请求,需先确认它的实际行为:
- 单次探测是否复用连接?默认是短连接(HTTP/1.0 或未设 Connection: keep-alive),每秒 2 次探测 = 每秒新建 2 个 TCP 连接 + TLS 握手(若启用了 HTTPS)
- 请求体是否为空?check_http_send "GET /healthz HTTP/1.0\r\n\r\n" 是最轻形态;若带 Host 头或 Authorization,会增加解析负担
- 响应是否被完整读取?模块默认读取全部响应体,若后端返回 1MB 的 JSON,即使状态码是 200,也会带来 I/O 和内存压力
因此,性能测试第一步是抓包(tcpdump 或 Wireshark)或在后端打日志,确认心跳的真实请求头、连接模式、响应大小,并以此建立“纯心跳”基线。
分场景压测:隔离探测流量,观察资源水位变化
用 wrk / hey 等工具模拟不同强度的业务请求,同时开启/关闭心跳,对比关键指标差异:
- 关闭心跳时:仅施加目标 QPS(如 5000 QPS)的业务请求,记录后端平均 CPU 使用率、每秒新建连接数(ss -s)、P99 延迟、GC 频次
- 开启心跳时:保持相同业务 QPS,额外叠加心跳(如 interval=2s → 每秒 0.5 次/节点 × N 节点)。例如 4 个后端节点 → 每秒新增 2 个探测请求
- 对比两组数据中“每秒新增连接数”的差值、CPU 使用率上升百分比(建议关注 user 时间而非 sys)、以及慢日志中是否出现因健康检查触发的线程阻塞
重点看:心跳带来的连接增长是否远超业务请求本身(比如业务 5000 QPS 新建 5000 连接,心跳却新增 200 连接,就不可忽视);CPU 上升是否集中在应用框架的 HTTP 解析或 JSON 序列化阶段。

验证误判风险:注入故障,观察心跳反应是否引发雪崩
性能测试不仅是“跑得稳”,更是“出事时不乱”。可人为制造典型抖动场景:
- 让某个后端短暂卡顿(如用 sleep 3s 模拟 GC STW),观察心跳是否在 fall 阈值内准确标记为 down,且不导致其他节点连接池被占满
- 将后端响应时间从 20ms 突增至 800ms(仍返回 200),检查 timeout=1s 是否能及时中断探测,避免探测线程堆积
- 故意让健康接口返回 429(限流)或 503(维护中),确认 check_http_expect_alive http_2xx 是否正确拒绝,防止把“有策略的降级”误判为“宕机”而错误摘除
这类测试暴露的是心跳配置与后端真实行为的耦合缺陷——看似低开销的探测,可能因语义误判放大故障影响。
监控必须落地到具体指标,而非状态页
不要只依赖 /status 页面显示“all up”,要采集可聚合的数字:
- Nginx 侧:通过 stub_status 或 check_status 的 JSON 接口,提取每个 upstream server 的
check_count、check_fail、check_down,计算失败率是否随负载升高而异常上升(说明心跳线程争抢资源) - 后端侧:监控 JVM 的
http.server.requests指标,拆分路径维度,确认 /healthz 的 QPS 稳定等于预期(如 0.5 × 节点数),无突增或毛刺 - 系统层:用
perf top -p $(pgrep nginx)观察 Nginx worker 进程是否在ngx_event_connect_peer或 SSL 函数上消耗过高 CPU
真正的开销评估,是看到数字变化,而不是“感觉好像没影响”。






