





superclue正式发布deepseek v4 pro中文版权威评测报告。该模型于8月13日上线,智能体编程能力实现跨越式升级。其原生支持百万tokens级超长上下文理解,官方宣称在推理能力、代码生成、智能体任务执行三大维度已跻身国内第一梯队。
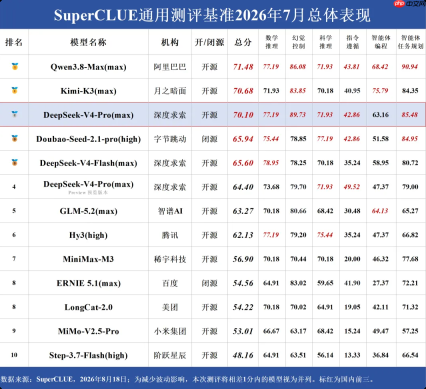
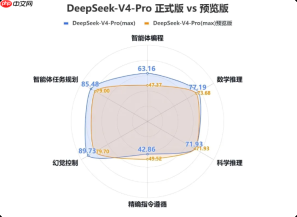
本次评测覆盖13款主流国产大模型,设置六大核心评估维度,其中智能体编程能力权重高达25%。相较于此前预览版本,DeepSeek V4 Pro多项关键指标显著跃升:智能体编程得分由47.37提升至63.16,增幅达15.79分;智能体任务规划能力提升6.48分;幻觉抑制能力从79.70分跃升至89.73分;推理响应效率亦同步优化。但精确指令遵循能力略有回落,反映出研发重心进一步向长程智能体协作与深度逻辑推理倾斜。

Unified LLM Gateway - One API for 70+ AI models. Route to GPT, Claude, Gemini, Qwen, Deepseek, Grok and more
下载
统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
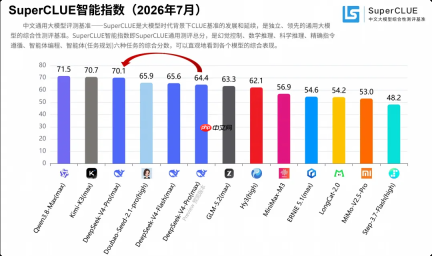
与Qwen3.8 Max横向对比可见,DeepSeek V4 Pro在幻觉控制与复杂推理方面表现更优,但在指令精准执行与智能体编程实操层面仍存提升空间,智能体任务规划得分差距约5分。需注意,所有测试均限定于纯文本交互场景,未接入外部工具或多模态环境,一定程度制约了智能体任务规划能力的充分释放。
综合来看,本次迭代的核心突破集中于编程理解与智能体协同能力,尤其适用于开发者进行代码辅助开发及高阶任务编排。然而能力演进并非全面均衡,部分基础能力仍有优化余地,用户在模型选型时应紧扣具体业务场景与功能诉求进行综合权衡。



