





nginx 的 virtual host 不支持主备自动切流,真正实现后端主备切换的是 upstream 模块;需在 http 块中定义 upstream,用 backup 标记备用节点,并配合 max_fails 和 fail_timeout 实现故障摘除与恢复。
这其实是个常见误解:Nginx 的 Virtual Host(server 块)本身不支持“主备服务器自动切流”。Virtual Host 是用来区分不同域名或端口的请求路由,不是做上游服务容灾的模块。
真正起作用的是 upstream 模块
主备切换、故障转移、健康检查这些能力,全部依赖于 upstream 块——它定义的是 Nginx 后端真实服务集群,而不是前端访问入口。
- 在 http 块里定义 upstream,列出多个后端服务器,用
server指令逐个添加 - 通过
backup关键字标记备用节点,它默认不参与负载,仅当所有非 backup 节点都不可用时才启用 - 配合
max_fails和fail_timeout实现自动摘除与恢复
一个典型的主备 upstream 配置示例
```nginx
upstream app_backend {
server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
server 192.168.1.11:8080 backup;
}
server {
listen 80;
server_name example.com;
location / {
proxy_pass http://app_backend;
proxy_set_header Host $host;
}
}

这样配置后,Nginx 会优先把请求发给 192.168.1.10;当它连续失败 3 次(如超时或连接拒绝),就会在 30 秒内不再选它;此时流量自动转向 192.168.1.11。
注意:这不是 Nginx 自身的高可用,只是后端容灾
上面方案解决的是 后端应用服务器宕机时的自动切换,但 Nginx 本体仍是单点——如果这台 Nginx 进程挂了,整个服务就中断了。
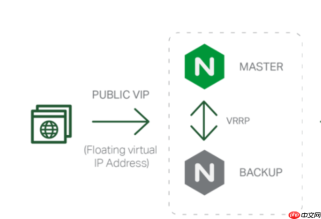
- 要实现 Nginx 本身的主备高可用,必须搭配 Keepalived + VIP 方案
- 即部署两台 Nginx 机器,用 Keepalived 绑定同一个虚拟 IP,靠 VRRP 协议实现主节点宕机时 VIP 漂移到备用机
- 此时 upstream 配置需在两台 Nginx 上完全一致,确保切换后行为一致
进阶建议:加健康检查接口提升可靠性
单纯靠 TCP 连通性判断不够准。推荐在后端服务上暴露一个轻量健康检查接口(如 /healthz),然后在 upstream 中启用主动健康检查(需编译 nginx-plus 或使用 openresty + lua-check);普通开源版 Nginx 可配合 keepalived 的自定义脚本做进程级检测。





