





backup 是故障兜底路由开关,仅在所有非 backup 节点被被动健康检查标记为 down 后才启用;其切换与恢复全自动,依赖 max_fails 和 fail_timeout 配置,无容错参数则形同虚设。
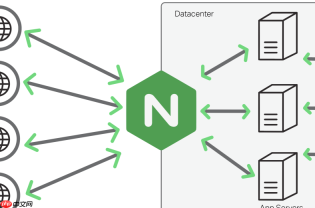
在 Nginx 反向代理中,backup 参数用于标记某台后端服务器为“备用节点”,仅当所有非 backup 的服务器全部不可用时才被启用,适合冷备容灾场景。
backup 参数的作用机制
backup 不是“热备”或“负载分担”,而是纯粹的故障转移开关。Nginx 会持续健康检查(需配合 health_check 或被动检测),只要至少一台非 backup 服务器可用,backup 节点就完全不参与请求转发。它真正生效的前提是:所有主节点连接失败、超时或返回错误状态码(如 502/503)且被判定为不可用。
基础配置示例
以下是最简可用的冷备配置:
upstream backend_cluster {
server 192.168.1.10:8080;
server 192.168.1.11:8080;
server 192.168.1.12:8080 backup;
}
其中 192.168.1.12 是冷备服务器,平时零流量。注意:
• backup 服务器不能和主服务器共用 weight、max_fails 等参数(除非显式指定)
• 若所有主节点都 down,Nginx 会立即切换到 backup,并持续尝试恢复主节点

配合健康检查提升可靠性
仅靠 passive 检测(如连接拒绝、超时)可能延迟发现故障。建议主动健康检查:
- 使用
nginx-plus的health_check指令(商业版) - 开源版可搭配
ngx_http_upstream_check_module(需编译安装) - 或通过定期 TCP 探针 + 自定义脚本 +
ip_hash/least_conn配合 fallback
例如开启简单被动检测:
upstream backend_cluster {
server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
server 192.168.1.12:8080 backup;
}
表示任一主节点连续失败 3 次(30 秒内),即标记为不可用,触发 backup 切换。
验证与注意事项
实际部署前需验证:
• 手动停掉所有主服务,确认请求是否自动路由到 backup
• 查看 nginx -t 和 error.log 中的 upstream 相关日志(如 “no live upstreams”、“using backup”)
• backup 节点自身也应具备完整服务能力(配置、数据同步、证书等)
• 不要给 backup 设置 weight 或 max_fails(除非明确需要控制其行为)
• 若使用 keepalive,需确保 backup 节点支持相同长连接策略





