





腾讯混元正式发布全新语音识别模型 hy asr3.0 preview,标志着语音识别技术正从“逐字转录”迈向“语境理解”的全新纪元。该模型依托最新一代大语言模型 hy3 构建,深度融合高保真语音识别与深层语义解析能力,其核心使命在于实现一次关键跃迁——让 ai 不仅能清晰捕捉每一个音节,更能真正领会话语背后的含义。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
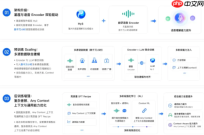
覆盖十大方言区,长时音频处理能力显著增强
在语言适配广度方面,Hy ASR3.0 Preview 并不局限于标准普通话,而是全面支持粤语、吴语等全国十大方言区域及超20个细分次方言片区。开源基准测试结果表明,该模型在多语种场景下的词错误率(WER)稳定维持在约3%水平:其中中文普通话为3.34%,英文为2.62%,粤语为3.12%,整体精度已达当前业界领先水准。
依托 Hy3 强大的上下文建模能力,模型可在转写过程中动态感知对话逻辑,精准识别用户真实意图,自动消解同音歧义,并智能替换误识词汇。尤其在会议记录、深度访谈等长音频、高复杂度场景中,“先理解、后转写”的范式展现出压倒性优势——传统方案面对同音异义常陷入识别僵局,而 Hy ASR3.0 则能依据语义连贯性自主推断最优文本表达。

使用 draw.io(.drawio 格式)和 SVG 生成兼容 Microsoft Visio 的架构图。当用户需要以下任一场景时触发: - 用于 Visio 或技术文档的架构/系统/网络图 - 带连接标注的分层控制系统图 - 将 draw.io XML 转换为稳定、可嵌入的 SVG - 修复 Visio 或 draw.io 无法打开的故障排查类图表 - 任何需专业级布局且文本可编辑的图表
MoE 架构驱动,千万小时级联合训练夯实底座
技术实现上,模型采用兼顾推理效率与建模能力的 MoE(Mixture of Experts)架构,底层基座全面升级至 Hy3。混元团队自主研发了无监督语音 Encoder,利用数千万小时海量未标注语音数据进行预训练,高效提取鲁棒、细粒度的声学特征——Encoder 专注“听得准”,Hy3 聚焦“想得对”。
数据构建策略强调协同演进:语音 Encoder 与大语言模型同步开展联合优化,整合来源多元、规模达千万小时级的语音语料;通过多阶段能力注入机制,赋予模型上下文感知力、多场景泛化力及方言兼容性。后续监督微调(SFT)阶段,则围绕通用识别精度、语境理解深度、复杂环境鲁棒性三大维度设计高质量训练方案,覆盖上下文依赖、专业术语、多样化声学条件及不同人群发音特性,并引入多轮强化学习持续攻坚长尾难点场景。
目前,Hy ASR3.0 Preview 已在腾讯云官网开放 API 接入服务,可广泛赋能智能客服系统、音视频内容分析、语音搜索等典型应用。腾讯自研 AI 助手“元宝”已完成首批集成,用户现已可通过语音输入,免费体验方言识别、上下文驱动的智能纠错、强噪声环境下的稳定转写等多项能力;WorkBuddy 等其他产品线亦正稳步推进接入进程。当语音识别由“听见字”进化为“听懂话”,人与 AI 的交互边界正被悄然重塑。





