





nginx event loop 本身不制造延迟,而是如实反映并放大底层系统瓶颈;其响应延时升高源于 cpu 调度争用、softirq 滞后、内存直接回收、accept 队列溢出及 tcp 慢启动等系统层问题,需结合内核参数与 nginx 配置协同优化。
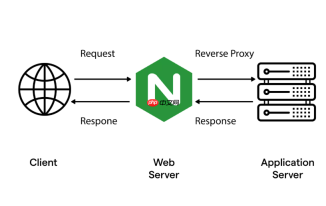
Nginx 的 Event Loop 本身不制造延迟,但它会如实反映并放大底层系统瓶颈。响应延时升高,往往不是 Event Loop “变慢”了,而是它正在等待 CPU 调度、内核事件通知、内存分配或网络数据就绪——这些环节卡住,Event Loop 就只能等。
Event Loop 延迟的真正源头在系统层
Event Loop 是单线程循环,依赖 epoll 等系统调用获取就绪事件。一旦系统负载上升,它的实际响应节奏就会被拖慢:
- CPU 高负载时,worker 进程被内核频繁切换上下文,epoll_wait() 返回后可能要等几百毫秒才轮到它执行回调
- 软中断(softirq)占用满一个 CPU 核(比如网卡收包密集),epoll 事件分发滞后,新数据到了内核缓冲区,但 Event Loop 还没收到通知
- 内存紧张触发直接页回收(direct reclaim),worker 在分配 SSL buffer 或 socket 内存时会阻塞数十至数百毫秒
- net.core.somaxconn 过低或 listen backlog 设置太小,连接卡在内核 accept 队列里,用户看到的是“连接建立慢”,实则是还没进 Event Loop
连接刚建立时的“慢”常被误读
新建连接处于 TCP 慢启动阶段,本身发包少、窗口小,导致内核接收缓冲区填得慢。Event Loop 只在有数据可读时才触发 read handler —— 它没“怠工”,只是没东西可处理。

- 启用 tcp_fastopen(客户端也支持)可绕过首次握手后的空等,缩短首字节时间
- 增大 somaxconn 和 Nginx listen 的 backlog= 值,减少 accept 队列排队
- 开启 multi_accept on,让单次 epoll_wait 后尽可能多地 accept 新连接,降低队列滞留概率
多级代理与重定向会把延迟“叠加上去”
Event Loop 不参与 TLS 握手、不决定 upstream 连接复用策略,但它必须等这些环节完成才能继续调度。每跳代理都意味着一次连接建立 + TLS 协商 + 缓冲决策,而这些耗时都会计入 $upstream_response_time。
- 关闭中间层 TLS(如 Nginx 到 Nginx 内网走 HTTP),只保边缘加密
- 对实时接口设 proxy_buffering off,避免逐跳缓存放大 TTFB
- 统一各级超时配置,防止某一级提前断连引发连锁 504
- 重定向尽量用 return 301 而非 rewrite,跳过正则匹配开销
可观测性要从 Event Loop 视角切入
不能只看 top 的 CPU%,需结合 Event Loop 行为判断真实瓶颈:
- 用 stub_status 查 Waiting 连接数:长期远高于 Active,说明请求堵在 accept 队列或 keepalive 等待中
- 用 pidstat -p $(pgrep nginx) 1 看 %wait:显著升高说明 worker 正在等 CPU 时间片
- 检查 dmesg | grep -i "tcp" 或 netstat -s | grep -i "overflow",确认是否存在队列溢出
- worker_cpu_affinity auto 必须启用,避免跨核迁移带来的缓存失效和抖动





