





openai的rsi焚诀,正式登场!
就在黄仁勋高调发文力挺开源权重之后,OpenAI也悄然转向“Open”路线——
其最新技术报告中,首次坦诚披露了部分RSI(AI递归自进化)的核心实践路径:
让GPT-5.6实现“左脚踩右脚”,自主重构支撑自身运行的底层系统。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
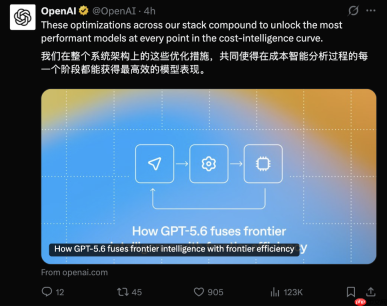
据该报告披露,GPT-5.6已正式接入OpenAI真实生产环境,承担起多项关键任务:实时分析线上流量分布、动态调整请求路由策略,甚至直接介入底层Kernel重写与推测解码模型优化。
这套组合操作落地后,OpenAI端到端服务成本下降20%,Token生成吞吐量提升超15%。
更引人注目的是,参与该项目的五位作者中,赫然包括Triton创始人、编译器领域权威——Philippe Tillet。
2021年,OpenAI发布Triton 1.0时,初衷是让非CUDA专家也能写出高性能GPU代码;
五年后的今天,GPT-5.6已能用Triton反向修改自己在GPU上运行的底层逻辑。
从“教人类写Kernel”,到“让模型自己改Kernel”,RSI的气息,已然扑面而来。
(难怪翁荔选择重返老东家——搞RSI,终究还得看OpenAI)
RSI焚诀,首战直指底层基建
此事之所以意义重大,正因其已初具RSI雏形。
所谓RSI(Recursive Self-Improvement),即递归式自我增强,本质是构建一个闭环:
AI能力提升 → 加速下一代AI研发 → 能力进一步跃升 → ……
诚然,GPT-5.6尚无法全自动训练下一代大模型,但它已开始深度参与自身运行系统的迭代升级:模型不再只是被部署与调用的对象,正逐步演变为系统架构的共建者与优化者。
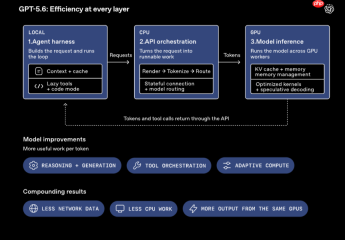
具体而言,它完成了以下四类关键动作:
1、剖析OpenAI真实生产流量特征
GPT-5.6持续监测各节点负载状态,识别服务瓶颈,并主动验证新型路由策略,将请求智能调度至最优计算单元。
2、重写并精炼生产级Kernel
它深入模型前向传播链路,识别可提前预计算、跳过或并行执行的模块,再借助Codex自动改写Triton与Gluon中的核心Kernel代码。
3、自主优化自身推测解码机制
GPT-5.6为draft model定制设计方案,并自动发起数百轮实验,遍历不同模型规模、结构及特征配置;训练过程中同步监控稳定性,遇硬件异常或收敛波动即触发干预。
4、按需匹配最优部署参数
面对短对话、长文本、代码生成等差异化任务场景,它可自动搜索batch size、模型分片(sharding)策略与KV Cache管理方案的最佳组合。
这四项能力串联起来,意味着GPT-5.6所参与的,已远不止单点代码优化,而是一条完整闭环的工程反馈链:
观测系统表现 → 定位性能瓶颈 → 提出改进方案 → 执行A/B测试 → 应对突发故障 → 将有效变更回滚至自身运行环境。
人类仍牢牢握紧方向盘
当然,真正的全自主RSI尚未到来,人类依然处于核心决策环中——即“human in the loop”。
尽管GPT-5.6开始参与系统改造,但优化目标设定、权限边界划定、效果评估标准,以及最终代码能否上线,均由工程师拍板决定。

通过本地 Codex 或 OpenClaw OAuth 凭证直接调用 ChatGPT/Codex Responses 的 image_generation 工具来生成或编辑光栅图像,然后保存
此外,模型内部优化再彻底,外部冗余开销依然显著。
例如,在ChatGPT Work与Codex处理复杂任务时,常陷入高频循环:
模型推理 → 调用工具 → 解析返回 → 继续推理
一次用户请求背后,可能经历十余轮乃至数十轮此类交互。
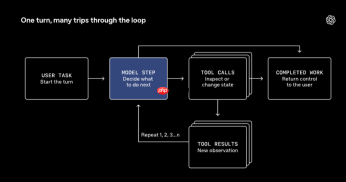
若某任务需调用模型30次,每次仅多耗1秒,累积延迟便达30秒;上下文指令、工具说明与历史结果亦在每轮中重复传输与计算。
为此,OpenAI专门构建了一套基于Rust的Agent Harness中间层,统一衔接模型、工具与用户环境,着力削减Agent循环中的重复负担。
其中两大关键设计如下:
1、按需供给:拒绝“信息轰炸”式提示注入
当前Agent虽支持海量插件、Skill与MCP扩展,但单任务往往只需极小功能子集。OpenAI摒弃“一次性塞满全部工具文档”的做法,改为在真正需要时才向模型呈现对应工具接口。工具响应默认限制在1万Token以内,超出部分需模型显式申请。
2、增量追加:保障Prompt缓存持续生效
Prompt缓存依赖上下文前缀的严格一致性。因此,新消息与工具输出仅追加至上下文尾部,绝不插入旧内容;工具调用顺序保持固定,权限校验与审批流程则延至执行阶段完成。
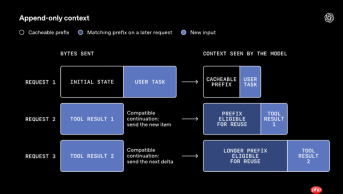
如此一来,GPU可复用此前已完成的计算状态,仅处理本轮新增输入,大幅降低重复计算开销。
单次循环节省有限,但当数以万计的Agent日均执行数十轮交互时,积少成多的效率增益便极为可观。
因此,本轮效能跃升实则源于双重合力:一边是GPT-5.6主动投身自身系统优化;另一边,则是人类持续为模型扫清运行环境中的冗余障碍。
人类仍在圈内,只是圈内的AI,已主动拿起扳手。
AI越高效,使用越频繁
除推动GPT-5.6参与系统自优化外,OpenAI技术报告还透露了一个重要现象:
在GPT-5.6内部灰度测试阶段,每位活跃研究员的日均输出Token量,已达GPT-5.5峰值时期的两倍以上。
过去半年间,OpenAI用于内部编程推理的研究型算力占比飙升100倍,Agent相关Token消耗量亦增长约22倍。
这些数字未必等同于研究效率同步翻百倍,但至少印证了一条规律:
当AI变得更廉价、更易用、更可靠时,它的实际使用强度不仅不会衰减,反而会呈指数级攀升。
参考链接
[1]https://www.php.cn/link/f20848a781e3554b876afadc3dc3281a
[2]https://www.php.cn/link/b2bda5107e30f358ff7e47bd0fe6c828
本文来自微信公众号“量子位”,作者:关注前沿科技,36氪经授权发布。





