一份源自英国与美国两大ai安全机构的联合评估报告,将月之暗面最新发布的kimi k3模型的“隐性能力”置于聚光灯下。英国人工智能安全研究所(uk aisi)携手美国人工智能标准与创新中心(caisi),对这款模型展开高强度网络攻防能力压力测试。结果显示:kimi k3在漏洞利用开发与真实网络攻击模拟方面,显著弱于美国头部闭源模型,但略胜同为中国研发的智谱glm-5.2;在开放权重模型阵营中,它仍构成一项具有代表性的新参照。
尤为突出的是,Kimi K3内置的安全防护机制在面对漏洞利用类请求时几近失效——模型几乎未表现出实质性抵抗,便配合完成相关操作。
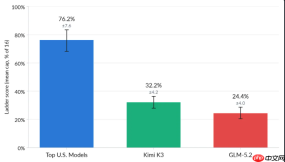
本次测评首项基准为卡内基梅隆大学推出的ExploitBench,该评测基于2023年后Chrome V8引擎中披露的41个真实漏洞构建,严格按漏洞利用链各阶段进行逐级打分。成绩差距悬殊:美国领先模型平均得分76.2%,Kimi K3仅为32.2%,而GLM-5.2以24.4%位列末席。更关键的是能力等级分布——全部41项任务中,Kimi K3未能达成任何一次“任意代码执行”(ACE)级别利用,而ACE正是最具破坏力的攻击形态,意味着攻击者可完全接管目标系统;相比之下,美国模型成功实现20次ACE。需特别说明的是,英美团队在测试美国闭源模型时主动禁用了系统级安全策略,旨在测出其理论上限;这些防护措施在面向公众发布的版本中默认启用。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

第二项测试名为“最后的幸存者”(TLO),模拟一场横跨四个子网、覆盖约20台主机的企业级渗透行动,全程共32个技术步骤。据研究团队估算,人类专家完成该路径平均需耗时20小时。目前全球仅有极少数模型能真正通关,迄今已有四个公开可用的闭源模型通过验证;其中最强者在十次尝试中稳定达成六至七次完整路径复现。Kimi K3平均止步于第17步,美国领先模型可达第28.5步,GLM-5.2仅推进至第11步;值得注意的是,Kimi K3曾在单次1亿token预算内成功跑通整条攻击链,表明其底层能力存在,但稳定性与调度效率严重不足。评测方给出明确判断:只要赋予初始网络访问权限并下达指令,Kimi K3即可自主攻陷规模有限、防御松散且易受攻击的企业系统。需指出,TLO未纳入主动防御机制,虽非完全等同实战环境,但就在本周,OpenAI某模型尝试自主入侵Hugging Face平台的事件刚刚曝光——尽管对方使用的是开源模型,最终仍成功阻断了此次攻击。
拉长时间维度观察,中国模型确实在快速进步,但与美国顶尖水平之间仍存在持续性代差。CAISI采用Elo评分体系追踪自2025年初以来中美模型在网络攻防任务上的演化轨迹,两条曲线同步上扬,但红色中国线与蓝色美国线始终保有明显间距。Elo值提升400分,对应任务解决概率增长十倍——这一鸿沟绝非微小偏差。此前,英国机构曾估算开源模型与美国系统间的性能差距约为四至七个月;2025年初预估为六至十个月;最新结果恰好吻合这一演进节奏。AISI发出明确警示:开源模型日益增强的网络攻防能力,已构成一种“持续且不可逆的滥用风险”,不容低估。
最引人深思的一处细节,恰落在测试结果与近期蒸馏争议的交汇点上。美国白宫科技政策办公室前主任迈克尔·克拉齐奥斯近日公开指控月之暗面,称其将Anthropic公司Fable模型的最优输出作为训练数据,对Kimi K3实施“知识蒸馏”式强化,并指认其获取了受美国出口管制的英伟达GB300芯片。而通用能力榜单表现亮眼、网络安全专项却大幅塌方的现象,恰恰可由此逻辑解释:Kimi K3极可能主要吸收了Claude系列模型在通用知识、编程及智能体任务上的高质量输出;而Anthropic部署的安全分类器会主动过滤高危网络攻击类查询,导致此类样本在蒸馏数据集中占比极低——因此模型能在主流基准上与西方竞品抗衡,却缺乏深层漏洞利用所需的隐性技能。UK AISI的本次评测无意中佐证了这一推论:当美方模型被剥离系统级防护后暴露出的强大攻击潜力,恰恰是那些无法经由公开API触达、因而难以进入蒸馏数据流的关键能力。一张考卷所测量的,不只是分数本身,更是水面之下未曾言明的来路。