





上海七月,暑气蒸腾。
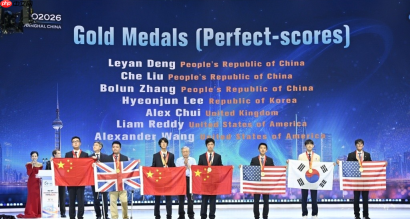
第67届国际数学奥林匹克竞赛圆满收官,中国队以232分傲视群雄,勇夺团体冠军。三名中国少年更是一举斩获42分满分佳绩。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
现场喝彩声犹在耳,GitHub上却悄然浮现出另一份令人震撼的榜单。
前Google工程师Deedy Das发起一场AI极限挑战:7款前沿大语言模型,全程自主攻克IMO 2026全部六道压轴题。
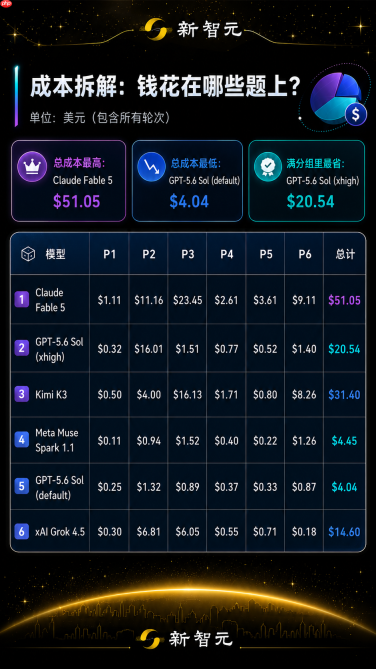
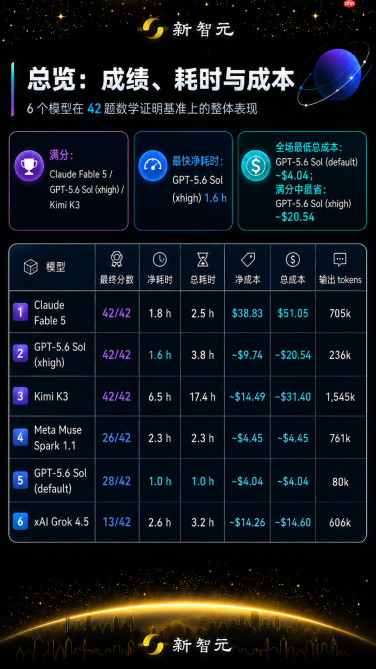
Claude Fable 5强势登顶,斩获42分满分。仅耗时2.5小时,总成本51美元。
GPT-5.6 Sol的xhigh版本同样达成满分成就。用时3.8小时,成本压缩至仅20美元。
Kimi K3紧追不舍,稳稳拿下满分。历经17.4小时连续推理,花费31美元。
再加上独立完赛的AxiomProver,四支AI队伍全部实现满分封神。
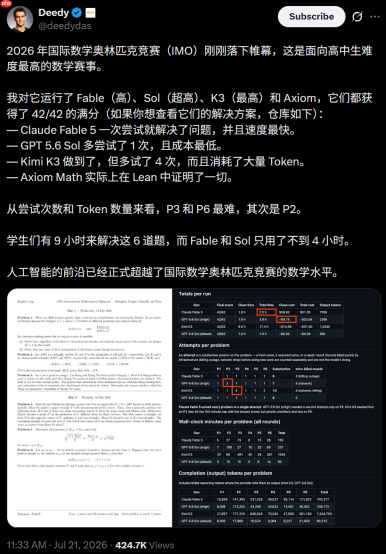
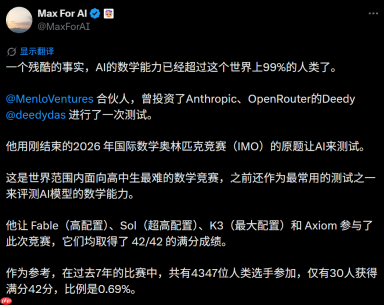
作为对比,过去七年IMO赛事中,共4347名人类选手参赛,仅有30人摘得满分——占比仅为0.69%。
成绩呈现断崖式领先
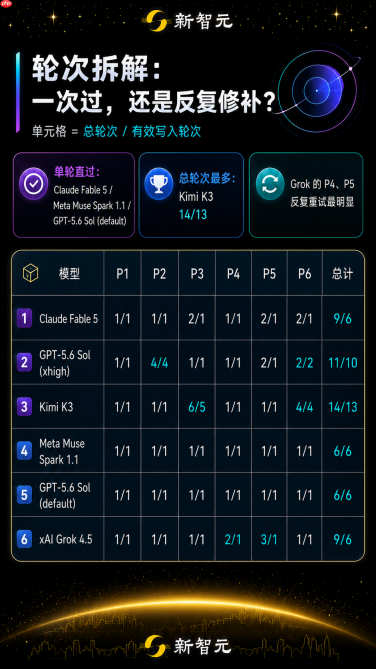
从最终得分看,满分42与第四名28之间横亘着14分的巨大差距;而三位满分AI的解题路径却各具锋芒。
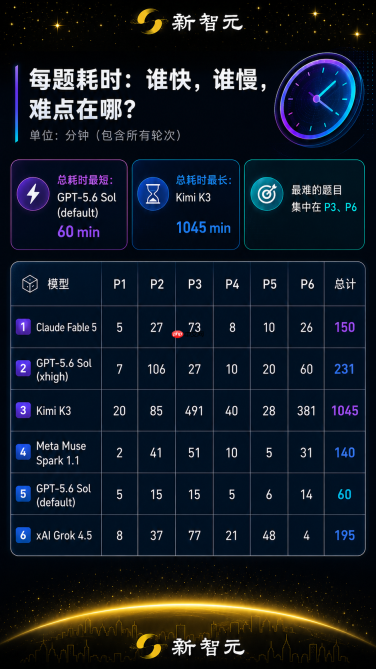
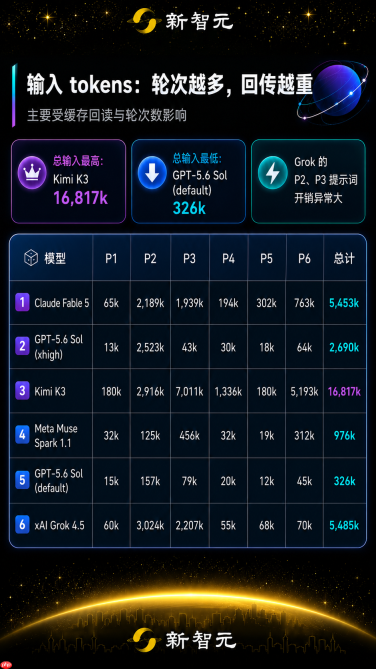
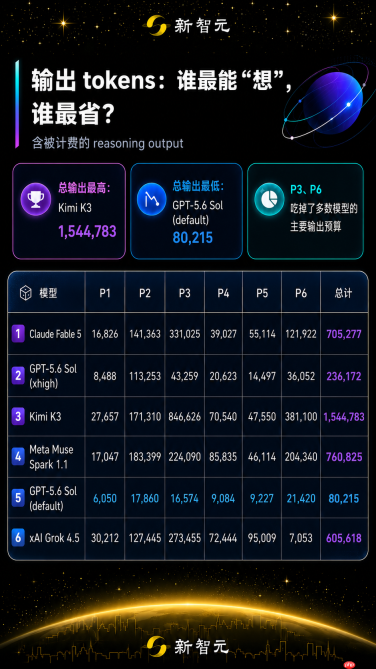
Claude Fable 5出手迅捷如电。全程仅9轮对话,其中6轮为有效输出;单次最长响应耗时73分钟(对应P3题),总计生成70万token。
GPT-5.6 Sol过程略显波折。在P2题上反复尝试4轮,耗时106分钟,期间遭遇两次网络中断。但其算力调度极为高效——总输出量仅23万token,是三者中最节省资源的。
Kimi K3则展现出惊人的持续作战能力。搭载2.8万亿参数的MoE架构,一口气输出154万token,达Sol的6.5倍之多。单就P3一题,便发起6轮攻坚,鏖战491分钟。
数学直觉的硬核对决
P1作为开篇热身题,所有模型均在数分钟内完成,人类选手亦几乎全员通关。
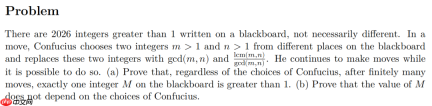
题目概要如下:黑板上初始写有2026个大于1的正整数。每次操作选取两个数m和n,擦除它们,并写下gcd(m,n)与lcm(m,n)/gcd(m,n)。重复该过程直至无法继续。需证明:(a) 过程必然终止,且最终恰好剩下一个大于1的数M;(b) M的取值与操作顺序无关。
为直观理解,我们先做一次简化实验:
假设黑板上仅有12和18。因12 = 2² × 3,18 = 2 × 3²。第一步:gcd(12,18) = 6,lcm(12,18)/6 = 6,黑板变为[6, 6];第二步:gcd(6,6) = 6,lcm(6,6)/6 = 1,黑板变为[6, 1]。此时只剩一个大于1的数,过程终止,M = 6。
无论操作顺序如何变化,M恒为6。原因何在?
关键在于素因子结构的守恒性。
对每个素数p,计算所有数中p的幂次的最大公约数,再将这些素数幂相乘——这一数值在每一步操作中始终保持不变。
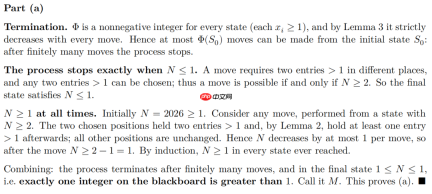
Claude Fable 5:自构单调递减计数器,一击破题。
Fable 5定义了一个复合量Φ = T + N。其中T为黑板上所有数的素因子总数(含重复计数),N为大于1的数的个数。例如黑板[12, 18],12含素因子2、2、3共3个,18含2、3、3共3个,故T = 6,N = 2,Φ = 8。
它进一步论证:每执行一次操作,Φ至少减少1。具体分两类情形——若gcd(m,n) > 1,则素因子总数T下降;若gcd(m,n) = 1,则T不变但N减1。由于Φ为正整数且每步至少减1,过程必于有限步内终结。单变量判定,逻辑凌厉。
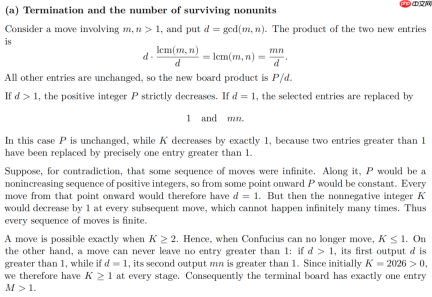
GPT-5.6 Sol:双变量字典序控制,降维破局。

Sol关注的是两个指标:P = 黑板上所有数的乘积,K = 大于1的数的个数。每次操作中,若gcd(m,n) = d > 1,则新两数乘积为mn/d,小于原乘积,P严格递减;若d = 1,则P不变但K减1。
于是二元组(P, K)在字典序下严格递减:要么P变小,要么P不变而K变小。而正整数的字典序不可能无限递减,因此过程必然终止。
两条迥异思路,殊途同归地攻下了(a)问。
进入(b)问,三大模型不约而同聚焦同一核心:对任意素数p,黑板上所有数关于p的指数的最大公约数在操作过程中保持不变。最终推导出的公式也完全一致——
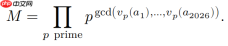
回看前述例子验证:12与18。对p=2,v₂(12)=2,v₂(18)=1,gcd=1,贡献2¹;对p=3,v₃(12)=1,v₃(18)=2,gcd=1,贡献3¹。故M = 2 × 3 = 6,与手算结果严丝合缝。
最省钱的未完成答卷
P6是Day 2的终极难题,要求证明某类递推序列终将呈现周期性。
去年IMO 2025全球仅6位人类选手成功破解P6。
Claude Fable 5:26分钟,两轮交互,满分通关。
GPT-5.6 Sol:60分钟,两轮交互,满分通关。
Kimi K3:381分钟,四轮交互,满分通关。
而Grok 4.5在P6上仅生成7053个token,全场垫底。提交文件中赫然标注一句:“Full proof: (Not yet complete.)”
花费仅0.18美元,堪称全场最廉价的空白答卷。
Grok的问题远不止于此。整场测试中,它频繁陷入一种奇特幻觉:反复坚称“证明已写入文件”,后台却从未调用任何文件写入工具。
这并非数学能力缺陷,而是agent层面的执行失能——模型清楚该做什么,也宣称已完成,但在工具调用环节彻底缺席。
三年三级跃迁
硅基智能的惊人跃进
2024年,DeepMind的AlphaProof首次在IMO级别逼近银牌线。
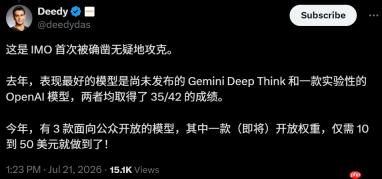
2025年,OpenAI与DeepMind同步发力。OpenAI某未公开模型解出5题,斩获35分金牌;Gemini Deep Think亦达同等水准。
2026年,三款通用大模型直接包揽满分。尤为关键的是,此次测试未进行任何专项数学微调,所有模型均为公开可访问版本,其中一款更是完全开源。
发出机器挑战书的青年
本次AI评测的起点,源自一家名为Axiom Math的初创公司。
该公司将IMO 2026全部六道试题,逐字逐句翻译为机器可解析的Lean 4形式化表述。
有了这套可被编译器直接验证的题面,AI得以输出标准Lean证明代码,并由系统自动判分,彻底摆脱人工阅卷依赖。
获得题面后,Deedy Das迅速构建起全自动评测流水线。各大模型随即在赛道上全速竞逐,逐一攻克全部六道难题。AxiomProver亦凭自身实力斩获满分。
值得一提的是,Axiom Math创始人洪乐彤年仅25岁。她出生于广州,仅用三年便拿下MIT数学与物理双学位,并荣膺Morgan Prize大奖。
去年底,她主导研发的AxiomProver一举摘得Putnam数学竞赛满分桂冠——这是该项赛事98年历史上第六次出现满分奇迹。
今年3月,该公司完成2亿美元A轮融资,估值飙升至16亿美元。
普通人日常将被怎样重塑
能写出4229行严密数学证明的模型,所掌握的远不止解题技能。
它真正驾驭的是超长链条的逻辑推演能力——每一步不可跳跃、不可出错、不可模糊。
合同条款是否存在漏洞?保险理赔是否满足条件?税务方案是否合规?剥开表层,本质皆属同类问题:答案绝不能“差不多对”。
以往这类逐条审验工作仅限专业人士完成,按小时收费。
如今,随着该能力逐步嵌入消费级产品,面对复杂问题,只需打开手机即可获得专业级判断。
参考资料:
https://www.php.cn/link/5a99388e5679d9b3fc492301a2b8e95a
本文来自微信公众号“新智元”,作者:ASI启示录,编辑:摩西,36氪经授权发布。









