





阿里巴巴正式推出全新一代图像生成基础模型——qwen-image-3.0。作为千问图像生成与编辑系列的第三代核心模型,该版本支持高达4.5k token的超长文本输入能力,可一次性精准生成涵盖数学公式、几何图形、逻辑推演过程、多层级ui界面等高复杂度视觉内容,并原生兼容12种语言及20余种字体渲染方案,显著增强面向商业场景的图文协同创作实力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
相较于前代模型,Qwen-Image-3.0将文本提示词最大长度提升至原来的4.5倍,在影视分镜脚本、知识可视化图表、产品说明书页面等高度依赖详尽描述的任务中,用户无需对原始需求进行删减或简化,可直接以撰写专业设计文档的方式,完整表达画面构图、文案内容、美学风格与排版规范,从而获得更贴合预期的输出效果,大幅减少迭代调试与人工干预成本。
在复杂语义理解与空间组织能力方面,Qwen-Image-3.0实现了进一步突破,具备单次生成九宫格式跨主题知识图解的能力,在确保文字辨识度的同时保障信息传达的准确性。此外,模型深度优化了多层逻辑嵌套解析能力,仅凭一条指令即可合成网页布局、软件操作界面、即时通讯窗口、营销海报等多种视觉组件的复合结构。例如,在“VSCode开发环境中,通过千问App生成一张用于聊天窗口发布的手冲咖啡推广海报”这类多层级交互场景下,模型能准确识别各层UI间的隶属关系与视觉一致性要求,甚至对约10像素大小的细小字号文本也能保持清晰可读。

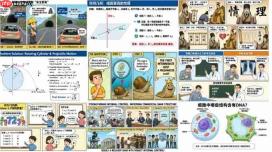
据官方介绍,Qwen-Image-3.0在人像写实摄影、中小学数学试卷、古代碑刻拓片、电商直播界面等多样化真实场景中均展现出卓越的细节复现能力,尤其针对图文交织密集、信息承载量大的任务进行了专项强化。
当前,生成式AI正加速渗透至专业设计与商业化内容生产流程,图像生成模型的竞争焦点已由单纯画质比拼,转向复杂信息表达精度、文本可读性以及工程落地稳定性。Qwen-Image-3.0的发布,标志着AI图像生成技术持续向高保真、多语种适配与产业级可用性迈进。









