





经历一轮人才流失与产品延期后,google 一项最早要到 2028 年才揭晓的隐秘项目悄然浮出水面。
据 The Information 援引多位直接知情人士透露,Google 正在秘密推进一款代号为 Frozen v2 的服务器级 AI 芯片,专为 Gemini 大模型深度优化。参与该项目的工程师表示,若以每瓦特所能生成的 token 数为衡量标准,其能效有望达到 Google 当前最新一代 TPU 的 6 至 10 倍。
“Frozen”这一命名,正源于其核心构想:将 Gemini 模型的部分结构永久性“固化”于芯片硬件之中。
大模型芯片:让模型架构“长”进硅基
要读懂 Frozen v2,需先回溯通用芯片的基本逻辑。
1945 年,宾夕法尼亚大学莫尔学院启动 EDVAC(电子离散变量自动计算机)的设计工作,它是早期存储程序式计算机的里程碑。在此之前,修改一段程序往往意味着重新插拔线路、拨动物理开关,整个过程耗时且极易出错。
数学家约翰·冯·诺依曼作为项目顾问,在团队讨论基础上撰写了《First Draft of a Report on the EDVAC》,首次系统提出“存储程序”概念:指令与数据共存于内存中,由处理器按序读取、解析并执行。
此后,“冯·诺依曼架构”成为通用计算设备的底层范式。
而指令集,正是这套范式的通用语——软件通过加法、加载、跳转等基础指令向处理器下达任务,处理器则依次完成取指、译码、执行三步流程。同一颗芯片,只需更换软件,就能从处理表格切换至渲染视频或运行游戏。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
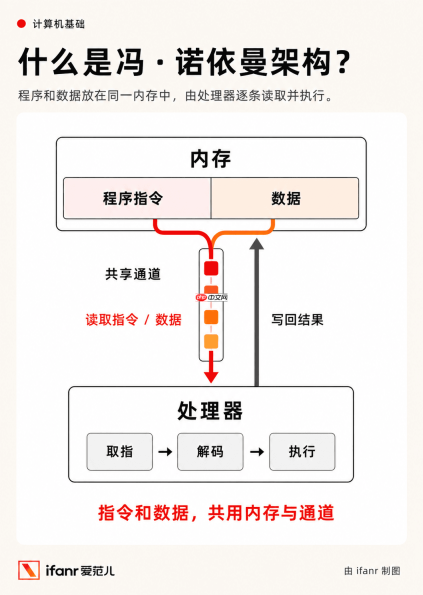
过去八十年,计算机的灵活性,正建立在这种软硬分离的基础之上。
但灵活,也意味着冗余。
大模型每生成一个 token,本质是反复调用矩阵乘、注意力机制等有限几类运算。而通用处理器却必须保留应对各类应用所需的控制单元、分支预测器、缓存一致性协议等复杂模块——其中许多部件,在纯推理场景下几乎完全闲置。
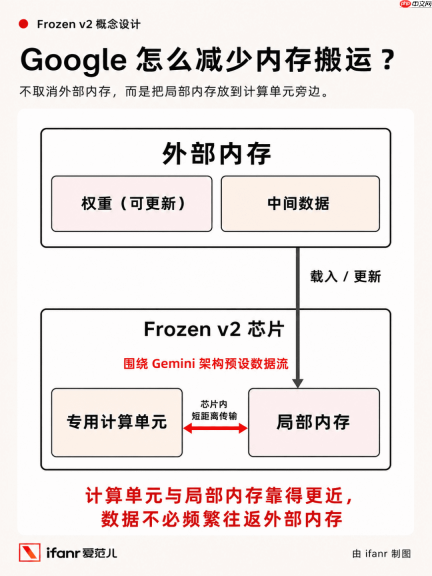
更关键的是,处理器与内存物理分离,导致大量数据在两者之间高频搬运。一旦算力提升速度远超内存带宽增长,芯片性能便会卡在“内存墙”上,难以继续突破。
为缓解这一瓶颈,行业先后催生了 GPU(专注图形并行计算)与 NPU/TPU(聚焦神经网络张量操作)。尽管它们已大幅优化特定负载,但仍需兼顾模型多样性,因此设计上仍保留相当程度的可编程性与通用性。
而 Google 选择了一条更激进的路径——Frozen v2 将围绕 Gemini 的固定拓扑结构,定制化布局计算单元、片上存储与数据通路,使硬件提前“预知”下一步最可能发生的运算,从而实现极致效率跃升。
简言之,Google 计划在芯片中“雕刻”Gemini 的架构层。
一个大语言模型通常由两部分构成:架构(定义信息流动方式,如 Transformer 的层叠结构)与权重(训练所得参数,决定输出内容)。
据悉,Frozen v2 将固化更多架构层面的逻辑,同时保留权重动态加载能力。它依然需要执行指令、访问内存,只是部分数据路径已被硬件预先锁定。
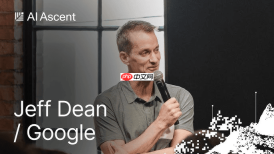
Frozen 系列项目由 Google 首席科学家 Jeff Dean 主导。作为 Google Brain 联合创始人、TensorFlow 核心设计者之一,他长期处于 Google 分布式系统与 AI 基础设施交汇的关键位置。
初代 Frozen 曾尝试将模型权重也一并固化进芯片,但由此带来的代价极为高昂:一颗芯片仅适配单一版本 Gemini。待芯片完成设计、流片、封装、部署,对应模型早已迭代数轮,硬件迅速过时。该项目一度因此搁浅。
Frozen v2 吸收了这一教训,明确保留权重更新通道。只要下一代 Gemini 维持相近的基础架构,该芯片即可持续服役。这不仅是技术路线的调整,更是 Google 对 Gemini 长期战略投入的公开信号。
大模型厂商,集体转向芯片自研
就在不久前,OpenAI 已用实际行动验证了“模型驱动芯片设计”的可行性。
2026 年 6 月,OpenAI 与 Broadcom 联合发布自研推理芯片 Jalapeño。该芯片并非凭空构想,而是基于 ChatGPT、Codex 及 API 实际负载建模,并引入 OpenAI 自身模型辅助完成部分电路布局与功耗优化。

Google Workspace 自动化,支持 Gmail、日历、Drive、表格,可通过服务账户或 OAuth 完成读取、写入、发送并管理整个 Google 套件。
从立项到流片仅耗时九个月,工程样片已稳定运行真实模型负载,预计将于 2026 年底起逐步上线部署。
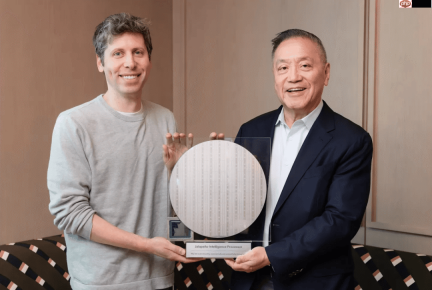
Anthropic 与 DeepSeek 同样被曝正推进自研芯片计划。尽管各家在专用程度上存在差异,但方向高度一致:掌握模型的公司,正将日复一日高频重复的计算模式,直接“翻译”为硬件逻辑。
我们已然步入“模型定义芯片”的新阶段。
那么,为何几乎所有头部大模型公司,都押注于自研芯片?
答案直截了当:压降算力成本。
以 Google 公开提供调用的旗舰模型 Gemini 3.1 Pro Preview 为例:在 20 万 token 以内,标准 API 定价为每百万输入 token 2 美元、每百万输出 token 12 美元。
假设一次中等强度请求含 5000 token 输入与 1000 token 输出,单次费用约为 2.2 美分。若此类请求日均发生 1 亿次,则每日支出达 220 万美元,年成本逼近 8 亿美元。
考虑到 Gemini 应用月活跃用户已突破 9 亿,哪怕单位算力成本微降 10%,乘以近十亿级调用量,也将带来数十亿美元级别的年度节省——对任何大模型厂商而言,这都是不可忽视的核心生存命题。
这场硬件豪赌,恰发生在 Google AI 业务跌宕起伏的关键节点。
2022 年 11 月,ChatGPT 横空出世。三周后,Google 高管层启动“红色警报”,CEO Sundar Pichai 亲自接管 AI 战略统筹。彼时的 Google 手握 Transformer 原始论文、全球最强搜索生态与海量数据中心资源,却在生成式 AI 入口之战中意外失速,被 OpenAI 抢先确立用户心智。
三年之后,战局一度逆转:Gemini 3 系列发布,Nano Banana 引发刷屏热潮,Google 重夺技术话语权,甚至被视为最接近 AGI 的科技巨头。
然而近几个月,Google 内部再度震荡加剧——
Gemini 联合负责人 Noam Shazeer 离职加盟 OpenAI;John Jumper 与多名核心研究员转投 Anthropic;原定于 6 月发布的 Gemini 3.5 Pro 被证实严重滞后,编码能力未达内部预期,Alphabet 股价随之连续下挫。
多位离职研究人员坦言,算力资源分配紧张是重要诱因。The Information 报道称,算力短缺曾迫使 Google Cloud 暂停承接部分外部客户订单;即便在 Google 内部,AI 团队申请算力也常需排队等待。
但 Google 手中,仍握有一张对手难以复制的王牌——从 Gemini 模型、TPU 芯片、Google Cloud 数据中心,到 Gmail、YouTube、Android 等庞大生态,整条技术栈均由同一主体掌控。这意味着,模型与硬件可围绕同一套目标协同演进,无需妥协。
顶尖人才或可被挖角,旗舰模型或会延期,但 Google 十年磨一剑打造的 TPU 架构、XLA 编译器栈、数据中心调度系统,不会因一次人事变动而瓦解。这是 Google 在 AI 时代最扎实的护城河之一。
当然,风险同样不容低估。
据消息人士透露,Frozen v2 芯片最早要等到 2028 年才进入实际部署阶段。而截至目前,Google 仍在权衡:究竟该在芯片中固化多少模型结构?这也构成了“Frozen”一词的第二重含义——为换取芯片级性能飞跃,Google 准备主动冻结 Gemini 的一部分演进自由度。
把大模型“刻”进芯片,是否真为最优解?答案或许要等到两年后才能水落石出。但留给 Gemini 加速追赶的时间窗口,确已所剩无几。
本文来自微信公众号“爱范儿”,作者:肖钦鹏,36氪经授权发布。











