





【导读】vla模型已具备任务执行能力,但真实机器人仍显迟缓!policytrim是一种专为提升vla机器人运行效率而设计的优化方法,无需重新训练。它通过延长高置信动作序列、剔除无效物理动作,引导机器人以更简洁路径完成任务,显著缩短整体执行时间。
Vision-Language-Action(VLA)模型将视觉输入、语言指令与机器人动作整合于统一策略框架中,使机器人可依据自然语言指令执行复杂具身操作。
从OpenVLA、OpenVLA-OFT,到π0.5、GR00T,该类模型正逐步成为具身智能发展的核心技术路径。
然而,当VLA模型实际部署至物理机器人平台时,一个关键制约因素迅速浮现:任务总耗时不仅取决于单次推理速度,更取决于策略需触发多少次推理、执行多少个真实物理动作。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
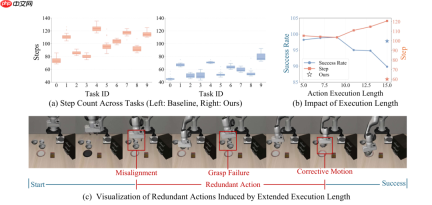
同一任务在多次运行中,VLA策略所需步数差异明显——表明更短、更优的成功路径本就存在,但当前策略往往仅能偶然抵达。
动作chunk尾部稳定性不足:模型一次预测多个连续动作,但越靠后的动作越易受误差累积影响;系统被迫频繁中断并重规划,强行拉长动作窗口反而降低成功率、增加物理步数。
物理动作高度冗余:即便最终成功,轨迹中仍常包含大量修正、回退与重复操作。
因此,VLA的实际部署效能,不能仅看单步推理延迟,更要关注“策略效率”(policy efficiency):一次预测中,有多少动作可被安全执行?完成任务究竟需要多少真实物理动作?
现有优化手段多聚焦于计算层面,如视觉token剪枝、模型量化、KV-cache复用、知识蒸馏或推理引擎调优。这些方法虽能压缩单次推理耗时,但若策略本身仍依赖大量冗余物理动作,则端到端任务耗时难以实质性改善。
盲目延长action chunk执行长度亦不可取。
论文实验表明:强制扩大动作预测窗口后,成功率可能下降,物理步数反而上升。这说明低质量尾部预测会将误差引入真实环境,迫使机器人投入更多纠错动作。
核心问题在于:能否在不损害任务成功率的前提下,通过后训练方式,让已有VLA策略自主习得“直击目标”的行为模式,以更少物理步骤达成任务?
四川大学雷印杰教授团队提出PolicyTrim——一种面向“策略效率”提升的两阶段强化学习后训练框架。该方法不改动VLA原始架构,也不依赖新采集专家数据,仅在预训练策略基础上进行轻量级行为优化。
项目主页:https://www.php.cn/link/1a534df4ec7023f89613a24be21a149f
论文链接:https://www.php.cn/link/a7a0a1f4201d3a346c365914c1ebb3bd
代码链接:https://www.php.cn/link/f5728573b5d4984431695a41396314be
模型链接:https://www.php.cn/link/7b5fb650c7bca123d83dd9cf7f7f9bca
新方法达成以下成果:
- 动作chunk有效利用率提升3倍,支持更长时域下的稳定执行;
- 物理步数减少51.4%,大幅削减纠错与重复动作;
- 在LIBERO Object/π0.5任务上实现最高5.83倍端到端加速;
从「算得更快」迈向「做得更快」
PolicyTrim并非旨在替代计算侧优化,而是补足长期被忽视的关键维度:降低完成任务所需的前向推理次数。它将策略效率解耦为两个可独立优化的目标——先拓展可靠动作窗口,再精简物理执行步数。
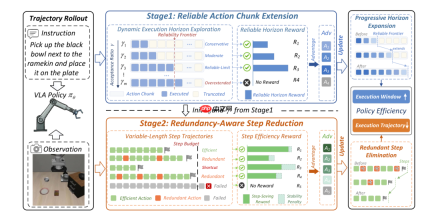
1. 可靠动作chunk拓展(Reliable Action Chunk Extension)
当前多数VLA策略以chunk形式输出动作序列,但实际部署中常仅采纳前几帧。PolicyTrim第一阶段采用动态执行窗口探索机制:在同一批rollout中分配不同接受比例,驱动模型在短、中、长多种窗口下协同探索其可靠性边界。

成功完成任务且使用更长窗口的轨迹获得更高奖励,激励模型提升原本不稳定chunk尾部动作的可用性。
horizon reward仅在组内出现至少一条成功轨迹时激活,防止模型在失败场景下盲目追求窗口延长。
2. 冗余感知型步数压缩(Redundancy-Aware Step Reduction)
在可靠执行窗口扩展完成后,第二阶段进一步压缩总物理步数。PolicyTrim引入step-saving reward机制:成功轨迹所用步数越少,奖励越高。
该reward直接将“更短、更优的成功路径”嵌入优化目标。
group-anchored regularization机制则抑制不可泛化的捷径行为,避免模型为追求步数缩减而牺牲任务成功率。
两阶段顺序优化有效规避“延长chunk”与“压缩步数”之间的目标冲突,最终显著减少完成任务所需的前向推理次数。
实验结果
研究团队在LIBERO、ManiSkill、Meta-World及真实机器人平台上全面验证PolicyTrim效果,并覆盖π0.5、OpenVLA-OFT、GR00T等多种主流VLA架构。总体结果显示:PolicyTrim在维持任务成功率不变的前提下,大幅提升执行效率。
在LIBERO基准中,π0.5模型实现最高5.83倍端到端加速,同时成功率稳定在98%以上。
跨基准测试显示,PolicyTrim在ManiSkill上最高达2.36倍加速,在Meta-World上达2.52倍加速。
跨架构测试表明,经完整两阶段优化的OpenVLA-OFT可获得2.97倍加速;仅启用第二阶段的OpenVLA亦可达1.41倍加速。
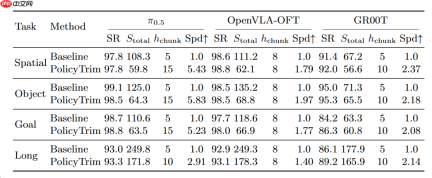
定性对比:路径更优,动作更凝练
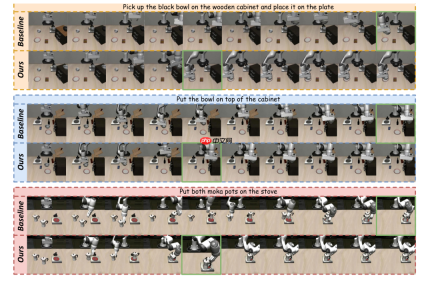
在随机抽取的LIBERO任务中,Baseline策略常出现反复修正、目标附近犹豫抖动等现象;而PolicyTrim生成的轨迹更流畅、更直接,通常仅需原步数约一半即可完成相同任务。
真实机器人部署:仿真增益可无缝迁移至物理世界
研究进一步在搭载双Intel RealSense D435i相机的Agilex Piper机械臂上开展真实任务验证,涵盖FlipMug、HangMug、TapeBox三类典型操作。实验包括固定目标位置的标准设定,以及抓取过程中随机扰动目标的动态设定。
PolicyTrim在标准与动态扰动两种设置下均保持或提升成功率,同时显著缩短真实执行耗时。在标准真实机器人设置中,平均实现1.86倍端到端加速。
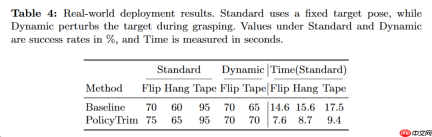
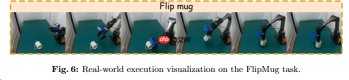
实验结果证实,PolicyTrim并非仅提升benchmark分数:在物理机器人上,任务完成时间亦可压缩至baseline约一半水平,且在动态干扰场景中展现出良好鲁棒性。
PolicyTrim为何有效?
• 直击策略行为瓶颈:减少冗余动作与非必要重规划,而非仅压缩单次推理延迟;
• 免重训轻部署:作为后训练框架,可在已有VLA模型基础上快速迭代,大幅降低数据与训练成本;
• 速度与成功率兼顾:通过可靠horizon扩展规避盲目扩窗风险,借助稳定性约束防止短路径投机;
• 与计算侧优化正交兼容:PolicyTrim优化推理次数,VLA-Cache等方法优化单次耗时,二者叠加可产生协同加速效应。
PolicyTrim的核心主张是:对VLA机器人而言,部署效率不仅源于模型推理更快,更源于策略行为更高效。让机器人“少绕弯路”,同样能带来可观性能跃升。
参考资料:https://www.php.cn/link/a7a0a1f4201d3a346c365914c1ebb3bd
本文来自微信公众号“新智元”,作者:新智元;编辑:LRST,36氪经授权发布。


