





近日,字节跳动正式发布全新音频生成模型——seed audio 1.0,标志着ai音频技术正从基础语音合成,全面升级为具备叙事能力的“全场景声音创作”新范式。该模型现已登陆火山方舟体验中心,面向广大内容创作者开放试用。
过去,影视级音频制作往往需调用多个独立模型分别生成人声、音效与环境音,再经人工反复剪辑、对齐与混音,不仅耗时费力,更易导致节奏断裂、情绪脱节,影响整体听感统一性。而Seed Audio 1.0的突破在于:它摒弃碎片化拼接逻辑,转而在统一建模框架下,对语音、音效、空间感等多维声学要素进行联合优化,实现端到端输出具备完整语境与情感张力的“可叙事音频作品”。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
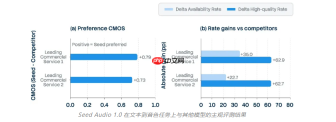
官方披露,Seed Audio 1.0具备三大关键能力。其一为高精度时空调度能力,支持以100毫秒为单位精细控制台词触发时刻与音效入场节奏,高度契合短视频配音、广告旁白等强时间敏感型创作需求;其二为高保真音色表达能力,无需参考样本即可生成稳定角色音色,并在长段落中持续维持声线统一,同时自然承载喜怒哀惧等复杂情绪变化,甚至支持单一声线差异化演绎多个角色;其三为本土化多语种生成能力,已覆盖中文、英语、日语等20余种语言,每种语言均适配本地发音习惯、语调韵律与重音分布,拒绝“翻译腔”。
实测结果显示,该模型在广告、有声书、游戏配音、教育讲解等九大主流音频创作场景中,首稿可用率超90%;多语种语音自然度MOS评分普遍达4.0以上(满分5分),达到专业级水准。
一款AI工具,主要用于使用 CodexBar CLI 本地成本使用情况,按模型汇总 Codex 或 Claude 的使用量,包括当前(最新)模型或完整的模型分解,适合需要提升相关任务效率的用户。
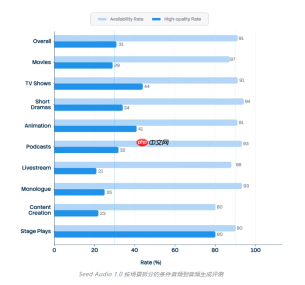
从“能发声”迈向“懂创作”,Seed Audio 1.0正大幅降低高品质音频内容的生产门槛。后续研发将聚焦多模态融合,如引入视频画面作为生成参考,并探索语义对齐的可控语音翻译机制,持续强化长音频连贯性与分轨精细化控制能力,让创作者脑海中的声音构想,真正“一键成声”。
项目主页:
https://www.php.cn/link/0ff0ca3dffc1a64964edbd3b1d14f85d
体验入口:
火山方舟体验中心 → 登录 → 选择语音模型 → 语音合成 → Doubao-音频生成-1.0





