





nginx master进程通过定期调用waitpid()检测worker异常退出(非零退出码),自动fork新worker;新进程复用已创建的监听socket、共享配置与内存,实现快速启动;若1秒内异常退出≥10次,master主动退出并需人工干预。
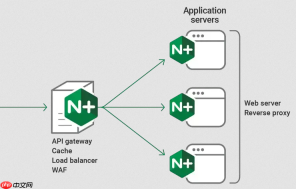
Nginx 的 Master 进程本身不处理请求,它的核心任务之一就是保障 Worker 进程的持续可用——当某个 Worker 崩溃时,Master 会自动拉起新进程,整个过程对服务几乎无感。
Master 检测 Worker 异常退出的方式很直接
它不依赖信号通知,而是在自己的事件循环中,定期调用 waitpid()(带 WNOHANG 标志)轮询子进程状态。只要发现某个 Worker 进程已终止,且退出码非零(比如段错误、被 kill -9、OOM Killer 杀掉),就判定为“异常退出”。
正常退出(如 reload 或 graceful shutdown)时,Worker 主动返回 0,Master 识别后不会拉起新进程。

确认异常后,Master 立即 fork + exec 启动新 Worker
这个新进程能快速接手服务,关键在于:
- 监听 socket 已由 Master 提前创建并保持打开(设置了
SO_REUSEADDR,必要时支持SO_REUSEPORT) - 配置已在 Master 地址空间解析完成,fork 后通过写时复制(COW)共享
- 共享内存区(如
limit_conn)、全局锁(如accept_mutex)等也由 Master 初始化,新 Worker 直接映射使用
所以新 Worker 启动极快,没有冷启动开销,也不需要重解析配置或重绑端口。
有保护机制,防止雪崩式崩溃
Master 会统计最近 1 秒内 Worker 异常退出次数。如果 ≥10 次(硬编码阈值,不可调),Master 就主动退出,并在日志中留下提示:exit after too many worker processes exit unexpectedly
此时整个 Nginx 停止,必须人工介入排查,常见原因包括配置语法错误、第三方模块冲突、内存越界等。
注意:Master 不负责恢复自身故障
如果 Master 进程自己崩溃(比如启动时因配置错误 segfault、加载不兼容模块失败),这套拉起逻辑完全不生效。这类问题需手动检查日志、修正配置、重启服务。
不复杂但容易忽略





