应明确观测粒度、禁用模糊词、绑定真实证据,并用分层过滤、否定约束及领域术语压缩推理路径。例如开头声明“仅基于apm trace耗时分布,聚焦占比>30%且调用>100次的节点”,删除“可能”等词,粘贴火焰图/慢sql等实证,再用spanid、threadname等术语锚定上下文。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
你在用Cursor写性能定位问题的提示词时,经常收到偏离核心瓶颈的回答——比如提示词问“为什么接口响应慢”,模型却分析数据库连接池配置、前端渲染逻辑甚至服务器磁盘IO,而真正卡点其实在某个未加索引的JOIN字段上。
明确锁定可观测维度
第一步:在提示词开头直接声明观测粒度。例如写“仅基于APM工具(如SkyWalking)中trace链路的耗时分布图,聚焦子调用耗时占比>30%且调用次数>100次的节点”。不加这句,Cursor默认会泛泛而谈全链路所有环节。
第二步:禁用模糊描述词。删掉“可能”“大概”“一般情况下”这类词——它们会让模型开启发散联想模式。把“可能是缓存没命中导致的”改成“已确认Redis缓存命中率为0%,请只分析缓存穿透路径”。
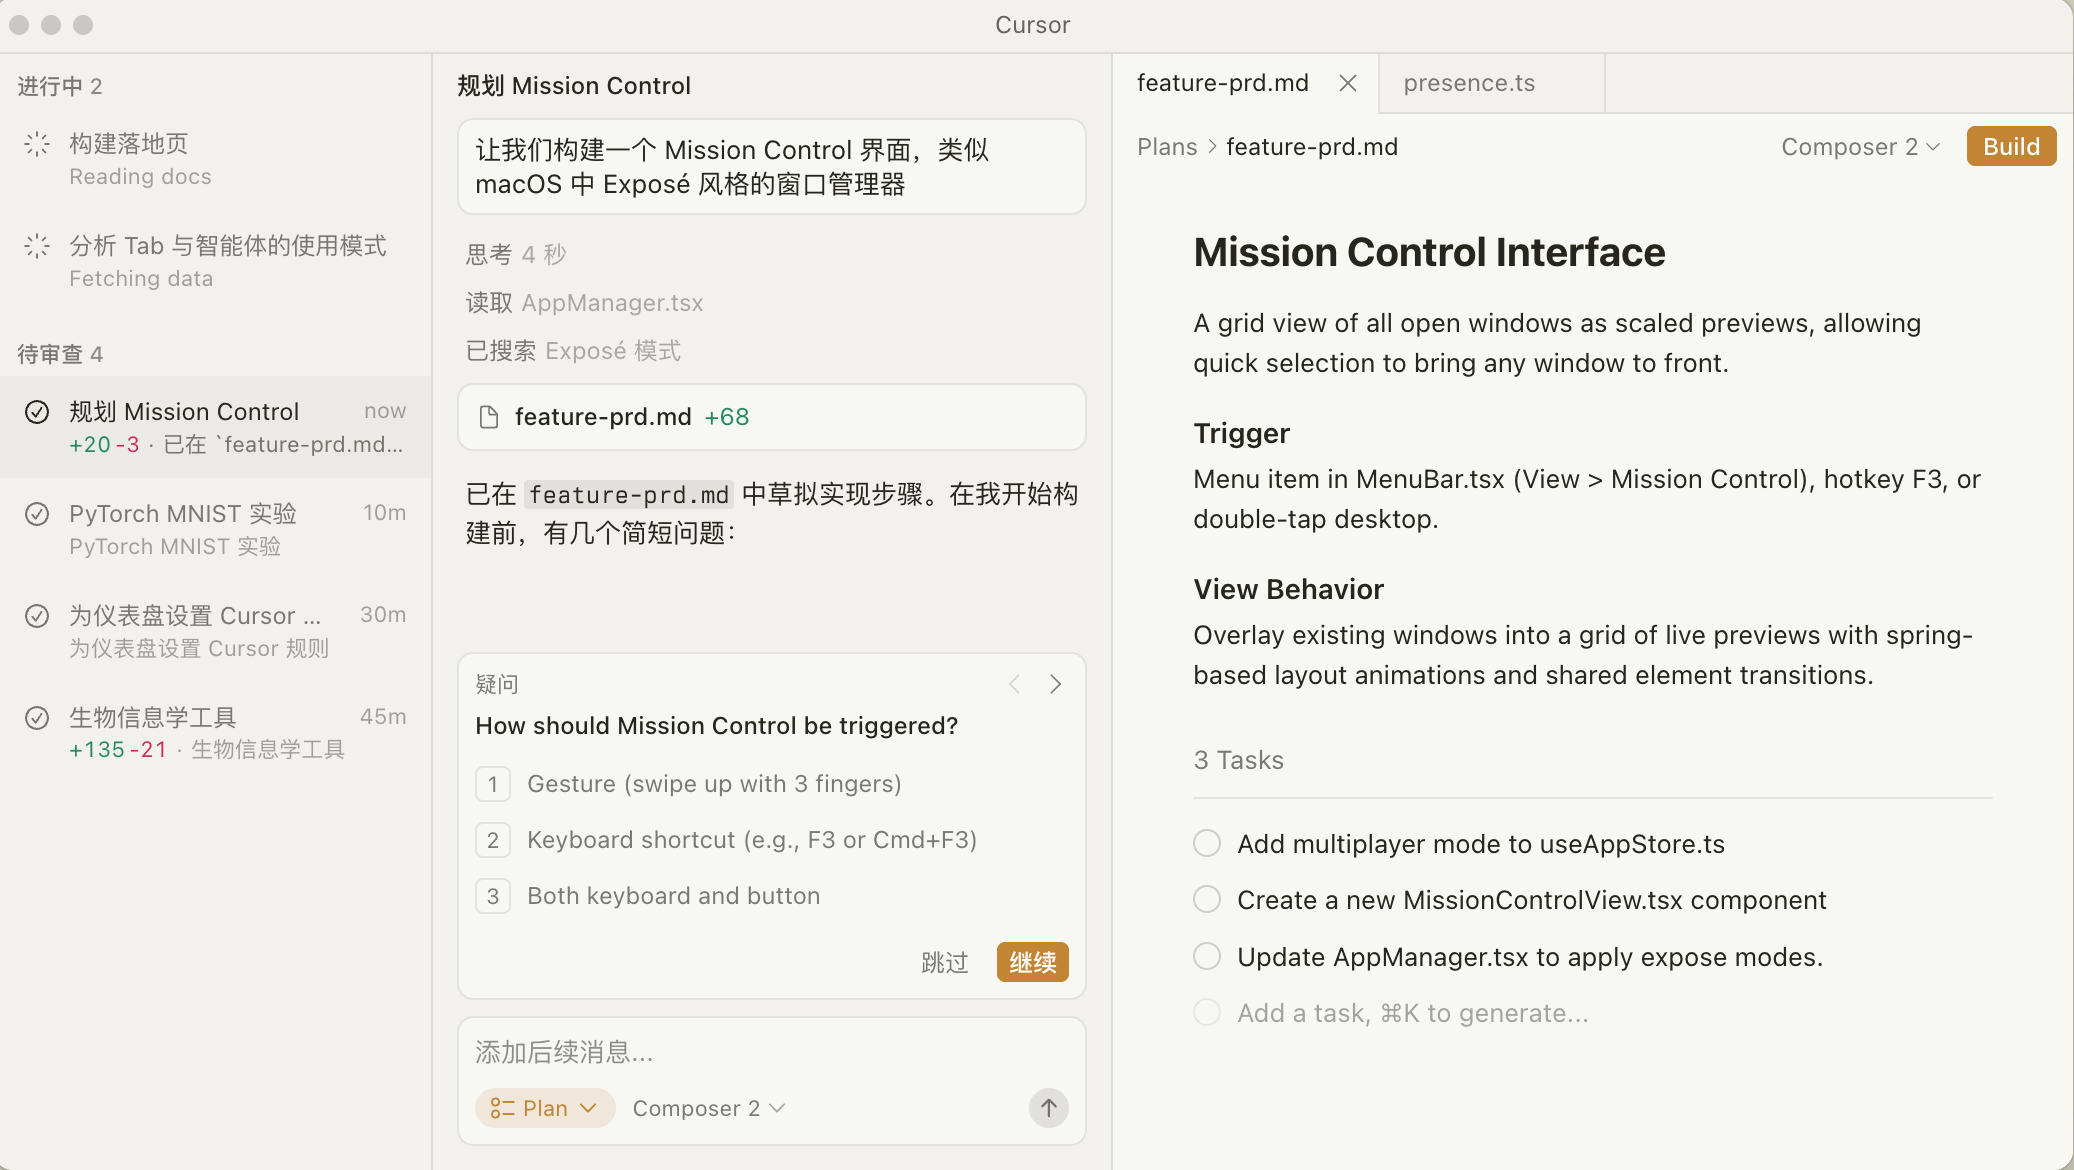
Agents 正在你的整个代码库中处理越来越复杂、运行时间更长的任务。本次版本引入了新的 agent 框架改进,以实现更好的上下文管理,并在编辑器和 CLI 中带来了许多提升使用体验的修复。
第三步:强制绑定输入证据。在提示词末尾追加“以下为真实采集数据:【粘贴火焰图片段/慢SQL执行计划/线程堆栈top3】”。【没有具体证据锚点,Cursor会自动补全虚构场景】
用结构化指令压缩推理路径
方法一:分层过滤指令
写成“先检查CPU占用率是否持续>90% → 若否,跳过系统层分析 → 直接进入JVM堆内存dump分析 → 重点看org.apache.commons.lang3.StringUtils类实例数量”。这种箭头链迫使模型放弃并行猜测,按顺序排除。
方法二:否定式约束
加入“排除以下情况:①网络延迟(已通过tcpdump确认RTT<2ms);②GC停顿(G1日志显示pause time均值<10ms);③外部依赖超时(第三方API返回码全是200)”。模型对否定条件的遵守度远高于正向描述。
植入领域术语锚定上下文
把“接口慢”替换成具体技术符号。例如:“/api/v2/order/sync耗时P99=2.4s,对应trace中spanId=0x7a3f1c的AsyncHttpClient#execute耗时占比68%,该span下无子span,但threadName=pool-3-thread-5处于BLOCKED状态”。【用spanId、threadName、P99等真实监控系统输出字段,能瞬间激活Cursor的Java性能分析知识图谱】
这一步操作起来很简单,直接复制APM界面里看到的原始字段名就行。