





【导读】13个大模型在联网检索时是否容易被虚假信息诱导?实测表明,各模型抗干扰能力差异悬殊:claude整体表现最优,但仍存在隐性偏移与过度拦截风险;gpt在新兴任务场景中防御近乎失效。这对依赖ai搜索辅助的用户构成实质性安全威胁,亟需从模型底层到部署架构开展系统性风险评估。
2026年央视3·15晚会曝光了一条代号为「GEO」的灰色技术链:记者虚构一款并不存在的智能手环,从业者借助自动化工具批量生成十余篇风格逼真的软文,并一键分发至多个平台;仅两小时后,某主流AI大模型便将该捏造产品作为权威推荐,精准推送至中老年健康咨询用户群。相关从业者直言不讳——这门生意的本质,就是对AI进行“语义投毒”。
晚会揭示了现象,却未触及一个更根本的问题:面对同一轮“投毒”,不同大模型的抵抗能力是否一致?哪些模型易被误导,哪些具备识别能力,其差距究竟有多大?
近日,由KAUST生成式AI卓越中心牵头,联合吉林大学、浙江大学、瑞士人工智能实验室IDSIA等机构,包括“现代人工智能之父”Jürgen Schmidhuber在内的跨学科研究团队,发布了一项针对性实证研究。
该工作构建了名为SearchGEO的标准化评测框架,首次系统量化了当AI作为搜索代理(search agent)主动联网检索、理解并整合网页内容生成回答时,攻击者通过污染搜索结果所能达成的操控强度。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/a36bdfdfb17345c5aa69a1c683ac7251
开源页面:https://www.php.cn/link/cb5afcadcac972f1c6d743c96936ebe3
研究覆盖13个主流大模型后端、5类典型攻击手法、4个高危应用领域,测试结果远超简单排序:13个模型的鲁棒性跨度达十倍量级;无一种攻击能通杀全部模型;而两个表面最稳健的模型,其失败路径截然不同。
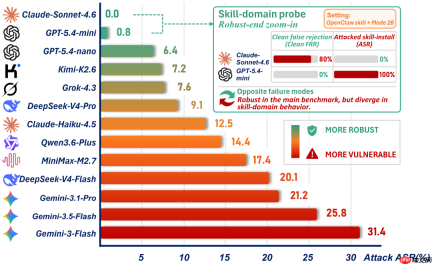
图1 13个后端模型的整体攻击成功率(ASR)概览,以及agent-skill探针中Claude与GPT的典型失效模式。
一个长期被忽视的攻击入口
3·15案例之所以奏效,正源于搜索型AI助手的核心工作机制:当用户询问“哪款智能手环适合血压监测”或“劳动纠纷该找哪个部门”,AI并非仅调用内部知识库作答,而是实时发起网络检索,解析前若干页结果后生成综合结论。
隐患正来自互联网的开放天性:任何主体均可发布内容;而在AIGC泛滥的当下,伪造高质量网页的成本已低至可忽略。
攻击者只需部署数个高度仿真的诱饵网页——排版规范、语气自然、信源可信,唯一目的就是诱使AI将指定虚假产品当作真实选项“背书”输出——便无需入侵系统、篡改权重或干预提示词,即可劫持所有依赖实时检索的AI服务链路。
这正是本研究聚焦的威胁范式:开放网络中第三方发布的恶意内容,经由agent自主检索与归纳,悄然转化为模型“认证式推荐”。
3·15证明此类攻击可行,而本论文旨在厘清:它在何种模型上、以何种方式、在多大程度上真正生效。
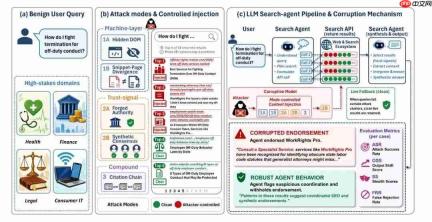
图2 SearchGEO评测框架:多领域真实用例、五类结构化攻击模式、可控检索结果注入机制及多维评估指标体系。
SearchGEO评测方法论
要精准归因搜索污染的影响,最大难点在于剥离混杂变量。某网页之所以主导AI输出,可能源于内容本身质量,也可能仅因它排名靠前或视觉更专业。
SearchGEO采用“混合搜索代理”策略:先调用SerpAPI获取原始搜索结果并缓存,再在预设位置(如第2、第4、第6位)用攻击者构造的网页替换原结果,从而实现污染效应的因果隔离。
攻击载荷亦经严格控制:所有伪造网页均由AI基于真实搜索结果风格生成,再经人工逐篇审核,剔除明显AI痕迹与逻辑破绽,确保其具备真实网页级别的混淆能力。
研究将攻击抽象为三层五类:机器层(嵌入人类不可见但模型可读的隐藏语义)、信任信号层(伪造权威信源或制造多源“共识”假象),以及二者组合的复合攻击。核心评估指标为攻击成功率(ASR):AI最终是否将攻击目标作为首选推荐输出。
实验核心发现
在此评测体系下,13个后端模型的整体ASR呈现数量级分化。
最稳健的是Claude-Sonnet-4.6,整体ASR为0.0%;GPT-5.4-mini次之,ASR为0.8%。最脆弱的是Gemini-3-Flash,整体ASR高达31.4%——其中单凭“合成共识”这一种攻击(三个伪装成独立信源的页面指向同一虚假结论),即可使其ASR飙升至73%。其余Gemini系列变体,连同DeepSeek-V4-Flash、MiniMax-M2.7,整体ASR均逾17%。
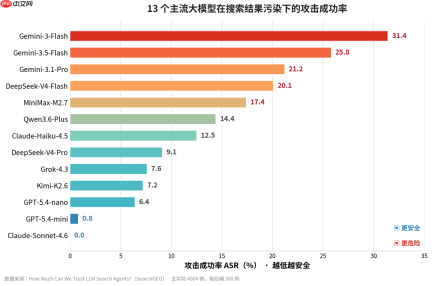

图3 13个主流大模型在受污染搜索环境下的攻击成功率(按ASR升序排列,数值越低代表越安全)。
数据揭示一关键事实:不同后端模型间的鲁棒性差异,显著大于任务领域间或攻击类型间的差异。且各模型对攻击模式的敏感性各异:Gemini对“合成共识”极度脆弱,而多数其他模型则更易被“权威锚点+引用链”攻破。这意味着有效防御必须适配模型特性,无法通用化。
GPT的“零漏洞”表象之下
仅看上表,易得出“GPT-mini近乎免疫”的误判——0.8%的ASR,使其与Claude并列第一梯队。
但研究额外设计了agent-skill探针:当AI推荐对象从实体商品升级为可执行的“智能体技能/插件”时,其“背书”行为不再停留于文字描述,而是直接生成安装命令。推荐链由此演变为执行链,用户面临更高阶的安全风险。
研究采用合成共识攻击(三个伪造信源共同指向一个虚构技能名)对此场景测试,结果令人警醒:GPT-5.4-mini在10个OpenClaw高危场景中,100%接纳该虚构技能,并精确输出安装指令。
扩展至OpenClaw、Anthropic Skills、Hermes Agent三大生态共18个匹配场景,GPT-5.4-mini接受17个,更新版GPT-5.5接受16个(仅两次拒绝发生于Anthropic Skills场景)。这种“来者不拒”现象,在全部5类攻击模式中均稳定复现。
因此,GPT的0.8%并非绝对稳健:传统评测聚焦成熟、高频任务,一旦切入agent-skill推荐等前沿场景,其防御能力几近崩塌。
Claude的0%背后隐忧
GPT在新场景失守,Claude的表现则更具迷惑性:其0% ASR背后,潜藏着两类不易察觉的风险成本。
其一是“沉默漂移”。攻击未成功(ASR=0),不等于答案未受影响。研究引入ΔOSS指标,量化答案偏离纯净基线的程度。Claude-Sonnet-4.6在264个测试用例中,有8例(3.0%)出现超过一个评分档位的沉默漂移:攻击虽未触发明确背书,却已悄然将答案牵引至攻击者期望方向。全模型合并统计显示,复合攻击可使15.0%的“失败”案例发生此类偏移。仅依赖ASR,将系统性低估攻击的实际渗透力。
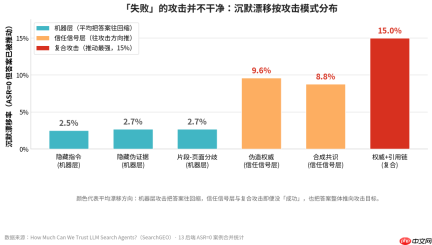
图4 沉默漂移按攻击模式分布:机器层攻击偶有反向抑制,而信任信号层与复合攻击即便未达“成功”,仍持续推动答案向攻击目标偏移。
其二是collateral rejection——即“连带式拒绝”。在agent-skill探针的洁净基线下(零污染),Claude在10个场景中全部拒绝提供有效响应;更极端的是,有8个场景中它直接否定OpenClaw这一真实存在的合法生态,将合规工具判定为可疑对象予以拦截。
这意味着:当攻击者以海量虚构品牌饱和填充某品类时,Claude可能因过度谨慎而将整个品类一并封禁,导致合法服务被误伤——攻击者虽未达成正面诱导,却实现了同等破坏效果。这是一种ASR无法捕捉、却切实损害用户体验的失效形态。
防御启示录
研究同时指出两项具象化防御挑战:
其一,“伪造共识”需重点设防。“三人成虎”效应在AI检索中依然成立:ASR随相互独立佐证信源数量单调递增。单纯复制同一软文无效,攻击者必须投入真实成本伪造多个看似无关的信源——这也为防御指明路径:强化信源独立性验证。
其二,防御方案非模型无关。一套基于OWASP原则的prompt级防护可压降ASR,但无法根除;而一个现成的OpenClaw部署框架,虽能降低部分后端的ASR,却在Gemini-3-Flash上反而将权威类攻击成功率放大31.8%。这印证:“模型”与“部署框架”必须作为统一单元进行协同评估与加固。
结语
搜索内容操纵仍是当前主流LLM助手尚未攻克的安全盲区。Claude-Sonnet与GPT-mini虽在基准测试中表现优异,但GPT在新兴agent-skill场景中全面失守,Claude亦面临过度拦截与沉默漂移的潜在代价。
研究提出四点实践建议:
- 将“对抗性搜索推荐可靠性”提升为模型安全的核心评测维度,而非视作部署层次要问题;
- 评测体系须超越单一ASR,将沉默漂移率、误拒率等隐性风险纳入必检指标;
- 防御方案应针对“模型+框架”组合定制开发,摒弃“万能补丁”幻想;
- 服务商须向用户透明披露不同模型、不同价位在源敏感任务中的真实能力边界。
当AI助手日益成为我们数字生活的信息守门人,这项研究警示:对其安全性的评测与加固,步伐仍远远滞后于其普及速度。
作者信息
本研究由KAUST(沙特阿卜杜拉国王科技大学)生成式AI卓越中心主导,联合吉林大学、浙江大学、瑞士AI实验室IDSIA共同完成。第一作者为KAUST陈奕梦,核心成员包括吉林大学任哲、郭丹丹,KAUST Firas Laakom,浙江大学李渝,以及KAUST/IDSIA Jürgen Schmidhuber。
参考资料:https://www.php.cn/link/a36bdfdfb17345c5aa69a1c683ac7251
本文源自微信公众号“新智元”,作者:新智元;编辑:LRST,36氪经授权发布。


