打开hugging face上longcat-2.0的页面,标题下方是logo与mit license标识,model introduction部分密集陈列着1.6万亿参数、480亿激活量、五万卡国产asic集群等硬核指标。但滚动至页面最底端,一个蓝色note框赫然写着:model weights coming soon — stay tuned!
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
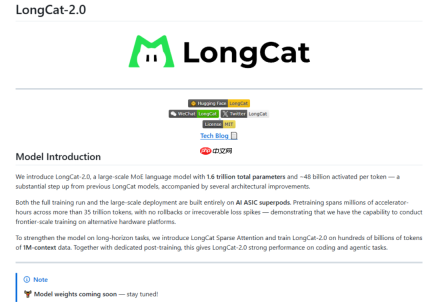
眼神锐利的美团,竟也玩起了“期房预售”——图纸已出,交房待定。
不过客观而言,美团此番确实在工程层面干了一件实打实的事:五万张国产专用AI加速芯片,不同于NVIDIA通用GPU,而是为大模型训练深度定制的ASIC架构。不依赖NVIDIA的NCCL通信协议(即GPU间协同的“内部对讲系统”),转而采用国产集群原生分布式通信协议,完整跑通了1.6T参数MoE模型从零开始的端到端训练。
1.6T总参数规模下,平均每步激活约480亿token,原生支持百万级token超长上下文。结合稀疏注意力机制、多专家动态路由等系列优化策略,据官方披露,这是国内算力生态中首次实现该量级模型的全链路自主训练验证。
再看评测成绩:SWE-bench Pro得分59.5,略高于GPT-5.5的58.6。过去三年,“模芯协同”口号喊得响亮,而美团这次交出了首份真正可运行、可验证的国产AI中期答卷。
但有三个最能体现国产技术成色的关键数字,至今未见披露:芯片由哪家厂商代工?整套训练投入多少成本?wall-clock time(真实训练耗时)究竟多久?——所谓wall-clock time,即从第一行代码启动到最终收敛所经历的实际物理时间,目前全部处于黑箱状态。

这三项数据一旦缺席,全国产链条的真实含金量、单位算力经济性、以及相较NVIDIA方案的效率落差,便无从量化评估。行业既无法横向对标,亦难复刻路径,更谈不上生态共建。
这有点像买房时想参观样板间,销售只递来一叠效果图。这个类比虽不完全贴切——毕竟模型确实已上线并可推理——但问题在于:若开发者希望按同样路径,在全国产环境中复现一次LongCat级别的训练,美团并未提供任何可操作的入口。
权重尚未开放,数据更是只字未提
美团宣称LongCat采用MIT许可证开源,听上去极为开放。然而点进Hugging Face主页,模型权重状态仍标注为coming soon,实质上属于“待开源”状态。截至目前,仅公开了推理框架与底层Infra代码;至于模型权重是否开放、何时开放、以何种许可方式开放,全部悬而未决。Infra与推理引擎虽已放出,但支撑其训练的35TB以上原始语料及清洗后数据,却连影子都未见。
仅开源权重却不开放训练数据,相当于只交付成品,不提供配方。开发者虽能调用API,却无法还原训练过程,本质上已构成“半开源”甚至“伪开源”。当前业界对大模型开源的基本共识,至少涵盖权重、代码、训练数据构成比例与预处理流程三要素,确保第三方具备微调乃至二次预训练能力。而LongCat目前仅释放推理侧能力,训练侧信息全面空白,其定位更接近一款免费商用的闭源模型。
不妨对比DeepSeek V4:权重、代码、数据配比全部公开,社区复现门槛极低;但V4并未强调“五万卡全国产链路从零训练”的工程闭环。LongCat则反向操作:训练全栈国产化,但权重与数据严密封存。一边押注全栈自研,一边押注全量透明,双方都尚未抵达终点。


美团暂不公开数据也在情理之中。LongCat训练语料中极可能包含大量业务敏感数据——外卖订单流、商户运营日志、用户评价文本、实时地理轨迹等,均为核心商业资产,自然不可能对外公开。但若连数据来源结构、采样逻辑与清洗规则都不予说明,外界就难以判断测试集是否存在数据泄露风险,其59.5分的评测结果,目前只能依赖企业单方面背书。
全球调用量跻身前三:靠的是低价策略与海量免费额度
LongCat曾以Owl Alpha之名匿名接入OpenRouter平台试运行数月。OpenRouter作为第三方模型聚合与比价平台,堪称新模型打响知名度的“流量主战场”。
其月调用量一度冲入全球前三。靠什么?API定价仅为0.30美元/百万token,不足GPT-5.5(2.50美元)的八分之一,且设有高额免费调用额度。
OpenRouter榜单本就是新模型惯用的“声量速成班”。业内通行做法是在发布初期以低价+赠额抢占榜单,积累口碑后再逐步提价。换言之,几乎没有任何新模型的榜单排名,是纯靠付费用户支撑起来的。真正的考验在于:当免费额度耗尽、价格回归常态之后,这个“前三”还能维持多久?
性能维度,LongCat对标目标为Claude Opus 4.6,但Anthropic最新版本已迭代至4.8,技术窗口期仅剩数月。功能定位上,它本质是一款垂直模型,专为本地生活服务与智能编程代理(Agentic Coding)优化,在通用问答与多模态理解能力上,明显弱于同期竞品。
刷屏全网的传播通稿中,几乎刻意淡化其“本地生活专属模型”的属性,转而将其包装成可比肩GPT系列的通用大模型突破。但事实上,无论训练目标设定还是数据底座构建,LongCat均围绕美团自有场景展开:商家智能助手、即时配送调度、到店运营决策……这一垂直定位本身并无问题,但若置于“国产算力自主突破”的宏大叙事中,极易被误读为通用大模型领域的全面胜出。
7月正值国产大模型密集发布期:Kimi K3以2.5万亿参数切入通用多模态赛道,对标OpenAI与Anthropic;百度文心5.0达2.4万亿参数,主打原生全模态融合;DeepSeek V4则以万亿级参数+极致开源策略,锚定“模型水电煤”定位;而美团LongCat以1.6万亿参数聚焦本地生活垂类。参数节节攀升,路线却愈发分化。资本市场催促大家比拼参数规模,但企业真实诉求,往往是将客服人力成本砍掉一半的轻量高效方案。
你向一家奶茶店主推荐1.6万亿参数的大模型,他只会问一句:“它能自动回复差评吗?”答案或许是肯定的,但一个小而精的模型同样能做到,根本无需动用万亿级算力。
按行业通行估算,五万卡集群三年折旧+电力+运维总成本逼近百亿元量级。美团依托外卖、到店、本地生活三大现金牛业务,足以平摊这笔巨额投入。而纯AI初创公司既无此现金流缓冲,亦无如此雄厚的基建底座,根本无力复制。阿里通义、京东言犀选择通用模型微调+快速业务嵌入路径,特点是轻、快、成本可控;美团则坚持全栈自研+从零训练,特点是重、慢、护城河深。两条路径并无高下之分,但中小厂商显然不具备效仿LongCat的现实条件。
LongCat的工程价值毋庸置疑,但这条路径注定难以规模化复制。国产算力迈出了关键一步,证明这条路走得通;但能否走得远、走得稳,关键还得看那把“钥匙”何时交付。
掌声,或许可以稍缓片刻
国产AI领域从来不缺“突破”“超车”“首个”的宣传口径,缺的是敢于公示真实成本、公开核心供应链、允许全行业复现验证的坦荡。
对整个产业而言,真正的“交付标准”应至少包含三点:芯片型号与集群配置可交叉核验、模型权重可一键下载、训练数据构成与清洗规则可完整追溯。在此之前,它更接近一场高规格的工程演示,而非可供广泛调用的公共基础设施。
一家企业的里程碑,无法自动铺就整个行业的高速公路。楼宇再高,若钥匙不交、账单不晒、路径不说,就永远只是别人家的楼。在权重可下、成本可核、数据可溯之前,这一次的掌声,不妨先按下暂停键。