





在生物技术迅猛演进的背景下,如何快速、精准地解析海量且结构复杂的生物信息,正日益成为科研人员亟需攻克的关键难题。为提升人工智能模型在该领域的实际研究效能,openai 最近正式发布全新评估体系——genebench-pro。该基准聚焦于检验 ai 在基因组学、蛋白质组学等核心生命科学任务中的真实科研能力,尤其关注其在数据噪声大、缺失严重及存在干扰因素等非理想条件下的推理判断与策略调整水平。
与常规评估标准相比,GeneBench-Pro 具有本质性差异。传统评测多依赖模型对已有知识的记忆强度或对预设步骤的机械执行能力;而 GeneBench-Pro 则以科研实践为导向,强调模型在逼近现实实验场景中的适应力与决策质量。所有测试任务均刻意构建于“模糊性高、信息不全、混杂干扰项”的数据基础之上,促使模型主动开展探索性分析,从而更客观地衡量其科学思维深度。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
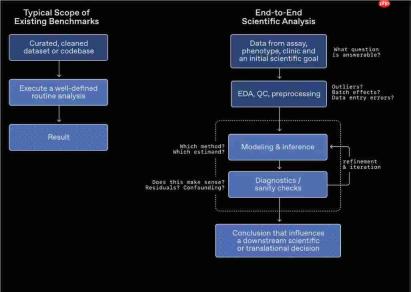
本基准覆盖基因组学、定量生物学及转化医学三大方向,共包含 129 道精心设计的题目,细分涵盖统计遗传学、群体遗传学、功能基因组学和蛋白质组学等多个前沿子领域。每道题均配备高度仿真的原始数据集,并仅提供简明实验背景与待解问题,要求模型自主识别分析路径、动态优化方法选择,并最终形成具备逻辑支撑的研究结论。

为规避传统端到端长流程评测中易出现的评分失真问题,OpenAI 在 GeneBench-Pro 构建过程中全面采用合成数据生成机制。此举不仅提升了数据可控性与可复现性,更能有效剥离模型因投机取巧或模式匹配所获得的虚假高分,使其表现真正映射出对生物学原理的理解深度与应用能力。
现阶段,OpenAI 已于 Hugging Face 平台开源首批 10 道典型 GeneBench-Pro 测试题,支持全球研究者通过交互式界面直接上手体验。下一步,OpenAI 将委托第三方专业机构 Artificial Analysis 对其中 50 道题目开展独立盲测,系统评估主流大模型在此新基准下的真实科研胜任力。








