





当ai跨越屏幕边界,真正融入现实物理空间,多模态模型正经历一场深层次的架构范式跃迁。
Om AI联汇正式推出全球首个专为物理世界打造的端侧流式多模态模型家族——VLX,首次在行业中定义并实现“流式多模态”这一全新架构理念。与传统视频理解模型将整段视频切分为固定帧、再进行批量离线处理的方式不同,VLX系列面向物理世界中不间断涌来的实时视频流,采用流式编码与缓存式增量推理机制,达成毫秒级响应的持续感知能力,并首次在终端设备上实现“持续感知→精准定位→自主决策→即时执行”的全链路闭环。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
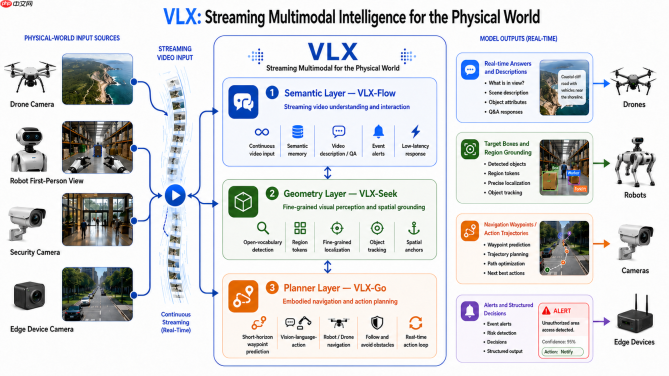
VLX模型家族由三款专业化子模型协同协作,共同构筑面向实时物理智能的完整技术栈:VLX-Flow承担持续感知任务,依托增量式编码与动态缓存推理机制,使模型具备类人的连续观察能力——不依赖用户提问触发,而是主动、不间断地吸收环境变化,新画面即刻纳入理解,响应指令零等待;VLX-Seek专注高精度空间定位,突破性地将坐标预测任务重构为区域检索问题——不再要求模型“估算坐标”,而是从预设候选区域中“匹配最优区域”,显著提升端侧设备的空间理解鲁棒性与可靠性;VLX-Go聚焦行动转化,直接将视觉语义解析结果映射为机器人可执行的短期航点序列与运动轨迹指令,跳过文本中间层,驱动设备自主完成目标跟随、动态避障与路径导航等物理交互行为。

在此范式下,视觉输入不再以“静态快照”形式被模型接收,而是以“连续时序流”方式实时注入;模型也不再遵循“看完再想”的延迟逻辑,而是践行“边看边解、边解边动”的实时认知范式。这所指向的,已非单纯的人机交互体验升级,而是AI在物理世界中实现真正自主作业能力的根本性突破。
为切实应对物理世界AI必须直面的三大硬性约束——时间不可中断、环境持续演化、终端算力高度受限,VLX系列并非简单将云端大模型轻量化后迁移至端侧,而是从底层架构出发,原生适配实时视频流与边缘硬件特性——以“快(流式推理,单路端到端延迟低至0.06秒)、小(模型规模灵活覆盖0.6B至10B参数量级)、准(支持厘米级细粒度空间定位)、行(打通感知—决策—执行全通路)”四大核心能力,构建起端侧具身智能的完整运行闭环。
当多模态模型从“单帧问答”迈向“长时序理解”,当AI真正走出屏幕、扎根现实世界,VLX端侧流式多模态模型家族,正为物理AI的发展开辟一条全新的架构路径——让每一台终端设备都具备持续理解环境、即时做出判断、自主采取行动的能力。这才是物理世界中AI本该拥有的形态。


