





使用mysql时,union 和 union all 的功能与适用场景常被初学者混淆。本文将深入剖析二者的核心差异,助你准确理解它们在结果集合并中的不同行为及执行效率特征。
1、 打开 Navicat 数据库管理工具
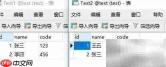
2、 查看本文所用的两张示例数据表结构与具体内容。
3、 观察发现:两表中均存在完全一致的记录(张三,123)。
4、 下面进入实操环节!
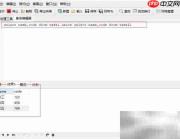
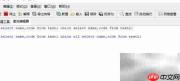
5、 利用 UNION 语句合并两个表的 name 与 code 字段:先从 test1 表中提取对应列,再与 test2 表中同名字段的结果集联合;系统自动剔除重复行,仅返回唯一值。
6、 查询结果如下图所示,一目了然。

7、 改用 UNION ALL 实现相同字段的合并:同样从 test1 和 test2 表中分别选取 name 与 code,但不执行去重逻辑,所有原始记录(含重复项)均完整保留。
8、 执行结果如下:
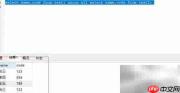
9、 对比两次查询输出可知:UNION 返回 3 条记录,而 UNION ALL 返回 4 条——多出的一条正是重复数据(张三,123),印证了 UNION 具备隐式去重能力,UNION ALL 则不做任何排重处理。
10、 本质区别在于:UNION 在合并过程中会启动排序与去重机制,保障最终结果集无重复;UNION ALL 直接拼接结果,跳过去重步骤,因此性能更高、响应更快。
11、 在实际开发中,UNION 因其语义清晰、结果可控,被更广泛地应用于业务查询场景。
12、 此外,借助 PL/SQL Developer 工具,可便捷完成 Oracle 数据库 DMP 文件的导出与导入任务。


