





nginx重试是需显式配置的被动failover机制,仅在error、timeout及显式声明的502/503/504等条件下触发,依赖多节点部署、合理超时设置(proxy_read_timeout与proxy_next_upstream_timeout协同)及upstream健康状态,非幂等操作应禁用重试。
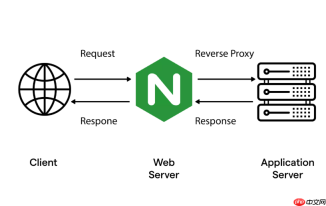
明确哪些错误会触发重试
默认只对 error(连接失败、被拒绝、重置)和 timeout(建立连接、发送请求、读响应头超时)重试;HTTP 状态码如 502/503/504 不在默认范围内,必须显式添加:
proxy_next_upstream error timeout http_502 http_503 http_504 invalid_header- 避免加
http_404或http_500:前者多是路径问题,后者可能是逻辑异常,重试无意义甚至有害 - 慎用
non_idempotent:它允许对 POST 等非幂等请求重试,极易引发重复写入(如下单、扣库存)
设置合理超时与重试边界
单次超时与整体重试窗口要匹配,否则重试可能根本来不及发起:

-
proxy_read_timeout 10s:等待后端响应头的上限;设太短会把正常慢接口误判为超时,设太长则用户等待过久 -
proxy_next_upstream_timeout 30s:从第一次请求发出起计时的总耗时上限(含网络延迟、重试间隔) -
proxy_next_upstream_tries 3:最多尝试 3 次(含首次),不是“额外重试 2 次” - 注意:
proxy_connect_timeout和proxy_send_timeout也需同步调低,确保各阶段超时逻辑一致
确保 upstream 具备可重试基础
重试的前提是有“下一个可用节点”,否则配置再全也无效:
- upstream 块中至少定义 2 台 server,且不能全部处于 fail 状态
- 配合
max_fails=2 fail_timeout=30s:某节点连续失败 2 次后,30 秒内不参与本轮重试候选 - 若用商业版或自行编译模块,可启用主动健康检查(如
health_check),比被动失败更早剔除异常节点
避免重试副作用的关键提醒
重试本质是 Failover,不是负载均衡,更不解决业务逻辑问题:
- 非幂等操作(如支付、创建订单)不应由 Nginx 层重试,应由业务层通过唯一请求 ID + 幂等表控制
- 长耗时接口(如 Excel 导入、报表生成)建议关闭重试:
proxy_next_upstream off,或单独 location 隔离配置 - 前端超时时间必须大于 Nginx 的
proxy_read_timeout,否则用户侧已断开,Nginx 重试成功也无意义





