





后端负载不均主因是配置策略、健康状态或请求特征与算法不匹配;应先区分流量分配不均还是实际处理压力不均,再选用least_conn、补全健康检查、按业务特征选hash策略等优化措施。
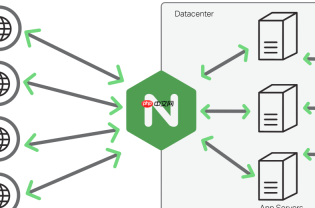
后端负载不均,通常不是 Nginx 本身“分错了”,而是配置策略、健康状态或请求特征与所选算法不匹配。关键要先判断是“流量分配不均”还是“实际处理压力不均”,再针对性调整。
检查是否真为分配不均
加权轮询(默认策略)只控制请求**数量**的理论比例,不反映 CPU、响应时间或连接数。比如:
- 某台 server weight=2,但它的接口平均耗时 2s,另一台 weight=1 却只要 200ms → 实际并发连接数可能严重失衡
- 大量长连接(如 WebSocket、SSE)持续占用单个 backend,而轮询仍不断派新请求过去
- 日志里看到某台 server 请求量明显偏离 weight 比例(如 3:1 配置下却接近 8:2),才说明分配逻辑异常
优先改用 least_conn 策略
当后端性能差异大、或接口响应时间波动明显时,least_conn 比加权轮询更贴近真实负载:

- 它把新请求发给当前活跃连接数最少的服务器,天然适配“慢接口拖累整体”的场景
- 配置简单,只需在 upstream 块中添加指令:least_conn;
- 注意:它不替代 weight,若需兼顾能力差异,可保留 weight 并启用 least_conn(Nginx 1.15+ 支持加权 least_conn)
补全健康检查参数,避免“假存活”节点吸流
一台后端进程僵死、TCP 端口仍通,但 HTTP 返回超时或 500 —— 默认轮询会继续转发,加剧不均:
- 给每个 server 加上 max_fails=2 fail_timeout=10s,让 Nginx 主动标记并临时剔除故障节点
- 若后端支持健康接口(如 /health),可用开源模块 nginx_upstream_check_module 做主动探测(需编译安装)
- 配合 down 或 backup 标记,预留人工干预通道
按业务特征选更匹配的分流策略
固定 IP 用户反复访问同一后端,可能因缓存/会话本地化导致某台过热;而随机 URI 则易引发缓存击穿:
- 有登录态或依赖本地 session:用 ip_hash 保证会话粘性(但需注意 NAT 环境下 IP 集中问题)
- 读多写少、静态资源多:结合 hash $request_uri consistent,提升缓存命中率,间接缓解后端压力
- API 网关类场景:可按请求头(如 hash $http_x_version)做灰度路由,隔离新老版本流量





