





一个 12b模型,凭什么让26b moe如临大敌?
2026年6月4日,Google正式推出Gemma 4 12B。官方措辞极为审慎:定位为E4B与26B MoE之间的中坚力量,可在配备16GB内存的轻薄本上本地运行,且采用Apache 2.0协议完全开源。
而DeepMind科学家Michael Tschannen的一条推文,悄然揭开了更深层的意图:“过去数年,我的核心研究方向是实现跨模态模型与训练范式的统一。今日发布的Gemma 4 12B,首次真正意义上直接接纳原始文本、图像与音频输入。”
关键词只有一个——“直接”。
“支持”太宽泛,“融合”太模糊,唯有“直接”,精准击中本质。
绝大多数科技媒体只热衷于炒作‘16G笔记本可跑’‘免费开源’两大卖点,却对此次发布所引爆的多模态底层架构革命视而不见。而这,恰恰是12B足以撼动26B MoE地位的根本原因。
不少报道将“无编码器”简单理解为“减法”:用仅35M参数的轻量嵌入模块替代动辄数百兆的ViT编码器,显存占用从15GB压至9GB,刚好适配消费级设备。这个观察没错,但远远未触及问题内核。
如果目标仅仅是降低显存,Google大可对现有26B MoE实施量化+知识蒸馏,无需彻底推倒重来。Gemma 4 12B是全新设计的产物——它追求的不是“把模型变小”,而是让原始音画信号零压缩、无失真地直通语言模型主干。
传统多模态的巴别塔困境:每一次转译,都是一次不可逆的信息蒸发
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
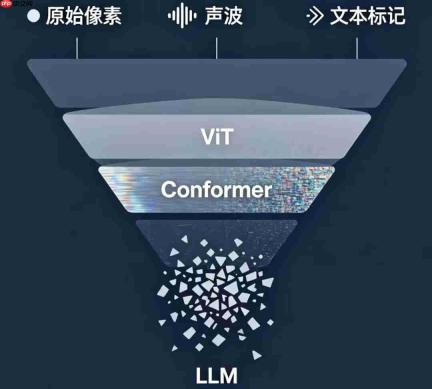
过去三年间,主流多模态方案——从LLaVA、GPT-4V,到Gemma 4 26B自身——本质上仍是“拼接式架构”。其内部逻辑高度趋同:
ViT编码器(通常含12–24层)将图像切分为patch,提取高维语义向量;Conformer或Whisper编码器则将原始声波转化为梅尔频谱,再抽象为声学特征。随后,两类特征各自经由对齐层映射至LLM的文本嵌入空间,最终才交由语言模型处理。
这套流程可以运转,但存在结构性硬伤:所有模态信息在抵达LLM之前,已至少经历一次有损压缩与语义转译。
ViT输出的是抽象特征向量,原始像素早已湮灭;Conformer输出的是高层声学表征,原始波形细节荡然无存。LLM实际接收的,是被层层提纯后的“二手信息”,大量空间结构、纹理细节与时序动态就此丢失。
更关键的是,三类模态的预训练目标彼此割裂:ViT专注图像分类,Conformer聚焦语音识别,LLM深耕文本建模。强行拼接时,必须依赖额外对齐训练来弥合鸿沟,“学会看图就忘了听声”的灾难性遗忘屡见不鲜。
编码器本身并无过错。真正的问题,在于“必须分层转译”的范式枷锁。一旦压缩发生,信息损失即成定局,无法回溯。
Gemma 4 12B没有选择修补这条旧管道——它亲手拆掉了整条管道。
视觉端彻底告别传统ViT编码器,改用仅35M参数的轻量嵌入模块:单次矩阵乘法 + 2D空间坐标嵌入 + 层归一化,图像块被直接投影至与文本Token完全一致的向量空间,随即无缝汇入Transformer主干的注意力计算流。特征提取,退化为纯粹的线性投影。
音频端更为激进:完全移除音频编码器,原始音频信号不做任何频谱变换、不提取声学特征,直接通过定制投影层映射至文本Token空间,原生声波直抵模型核心。
传统路径是“分而治之、再行拼接”,Gemma 4 12B走的是“混合Token序列、统一调度”。图像Token、音频Token、文本Token按时空顺序交织排列,共同输入同一套Transformer主干,由完全相同的注意力机制进行联合建模,共享全部权重与推理逻辑。
当然,各模态的投影层仍依其物理特性差异化设计:视觉需保留2D位置感知,音频需维持时序切片结构。但一旦进入主干,所有模态便共用同一套表征空间、同一套计算范式、同一套优化路径。
这正是Tschannen口中“统一”的真实含义。功能层面的“支持多模态”只是表象;架构层面的“全模态共享同一表征与计算底座”,才是本质跃迁。
实测逼近26B MoE:架构红利正重塑性能天花板
atomic.chat的实测结果极具说服力:在RTX 4090上,12B模型生成8.9k Token的物理仿真代码,显存仅占9GB,推理效率直逼26B MoE在15GB显存下的表现。二者参数量相差140亿,12B以不到一半的显存开销,实现了旗舰模型超五成的吞吐能力,且在代码质量、物理因果推理等关键维度几乎难分伯仲。
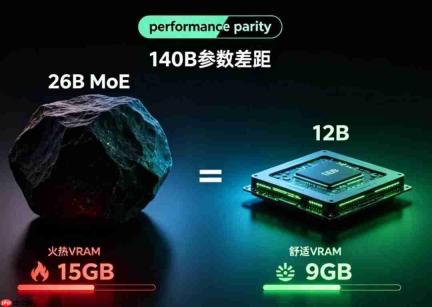
过往工业界惯性路径,始终围绕“堆MoE专家数、堆参数总量”展开军备竞赛。而Gemma 4 12B证明:架构级优化同样能兑现旗舰级效果,直接动摇“唯参数论”的研发信仰。这才是26B路线真正感到危机的根源。
显存大幅压缩,无独立编码器设计确为关键助力之一——既省去编码器自身的内存开销,也规避了编码器与主干之间特征对齐带来的计算损耗。但性能逼近26B,实为多重协同优化的结果:数据配比重构、主干计算密度提升、训练策略迭代均功不可没,不可单一归因。
真正的转折信号在于:Gemma 4 12B首次验证了“无编码器统一架构”在中等规模、可商用、可本地部署模型上的工程落地可行性。
这一验证完成之后,影响开始向多个维度扩散。
LoRA等轻量微调技术,理论上可直接作用于统一Transformer主干,从而同步优化全模态处理链路。不再需要分别冻结/微调编码器与主干,也不必为模态对齐问题反复调试。具体效果尚待第三方独立复现,Google亦未公开消融实验报告。
硬件门槛的下探则更为直观:多模态推理场景,正从“双路工作站+专业卡”下沉至“单张消费级显卡”。9GB显存即可原生运行多模态任务,这一临界点,直接决定了该技术能否真正融入普通开发者的日常工具链。
生态延展性亦值得期待。统一嵌入空间在架构层面天然预留扩展接口——新增模态理论上只需定制专属投影层,即可接入现有主干。但“可接入”不等于“即插即用”,配套的数据构建、任务定义与专项调优缺一不可。“零成本扩展模态”是误读,“架构级兼容潜力”才是准确表述。
边界与分水岭:领先不等于全能,但方向已然锚定
必须坦诚指出:Gemma 4 12B在应对超过三步的复杂任务链、多工具协同调用等强规划场景时,仍会出现路径偏移与逻辑幻觉。这并非缺陷,而恰是其处于“能对话”迈向“能做事”过渡阶段的自然体现。
初代智能手机的触控精度也曾饱受诟病,但方向早已确立。无编码器统一架构的可行性已被实证,后续的工程打磨,只是时间问题。
Gemma 4 12B的发布极易被淹没在“又一个新模型”的信息洪流中。但若放下参数对比表,细察其架构图,便会捕捉到一个清晰信号:
多模态AI的研发范式,正从“为每种模态定制专用转换器再缝合”,转向“所有模态共用同一套注意力引擎”。
12B的参数量本身无关紧要。它真正证明的是:多模态的“大一统”,无需靠堆砌模块实现;一套真正统一的表征空间,足矣。
未来两年,当业界回望2026年的多模态演进史时,Gemma 4 26B的基准分数或将淡出视野,而Gemma 4 12B所确立的架构选择,必将成为高频引用的关键节点。它是首个在中等规模、可商用、可本地部署的模型尺度上,成功验证“无编码器统一架构”量产可行性的里程碑。
26B赢下了当下的性能竞赛,
12B,改写了多模态AI的底层规则。
本文来自微信公众号“AI唱反调”,作者:李小文,36氪经授权发布。


