





要实现99.999%年可用率的keepalived双机热备网关,必须采用≥3节点多活集群、同步arp与连接状态、分层健康检查及物理级冗余隔离。
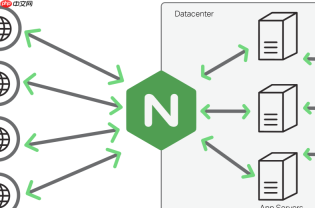
要构建年可用率 99.999%(即“五个九”,年停机 ≤5.26 分钟)的 Keepalived 双机热备网关,不能只靠“两台机器 + VIP 漂移”这种基础配置——那是为 99.9%(约 8.76 小时/年)设计的。五个九意味着系统必须消除所有单点隐患,包括网络、硬件、协议、运维和人为因素。以下是真正支撑 99.999% 的关键实践。
一、拓扑必须突破“双机主备”结构
纯 Master/Backup 模式存在隐性单点:VRRP 组本身只有 1 个 virtual_router_id,且依赖单播/组播链路健康;一旦底层交换机端口、VLAN、STP 收敛异常或 ARP 表老化不一致,VIP 切换可能失败或脑裂。
✅ 正确做法是采用 N+2 多活热备网关集群:
- 部署 ≥3 台 Keepalived 节点(如 web-gw01、web-gw02、web-gw03),全部配置为
state BACKUP - 使用相同
virtual_router_id和priority(如全设为 95),但通过nopreempt+preempt_delay控制抢占节奏 - 启用
vrrp_sync_group绑定多个 VIP 实现原子切换 - 配合 BFD(Bidirectional Forwarding Detection)检测下联链路亚秒级故障(需交换机支持或内核模块)
这样即使一台节点宕机+另一台网络抖动,第三台仍可稳持 VIP,避免“两台都自认 Master”的脑裂。
二、VIP 切换必须零感知、无丢包
用户 TCP 连接中断往往不是因 Keepalived 切换慢,而是因 ARP 缓存、TCP TIME_WAIT、连接跟踪表(conntrack)未同步导致。
✅ 必须同步完成以下三件事:
- 在所有节点启用
net.ipv4.conf.all.arp_ignore = 1和arp_announce = 2,确保仅响应 VIP 的 ARP 请求 - 使用
ipvsadm --sync-daemon或conntrackd同步连接状态(尤其对长连接如 WebSocket、数据库代理) - VIP 漂移后主动发送 gratuitous ARP(Keepalived 默认开启
garp_master_repeat,但需确认garp_master_refresh间隔 ≤1s) - 禁用
vrrp_strict(它会拒绝非标准 VRRP 包,反而在复杂网络中引发误判)
三、健康检查必须分层、可证伪、带兜底
仅靠 check_http 或 tcp_check 不足以支撑五个九。单一检查项失效(如监控页面返回 200 但后端 DB 已断连)会导致 VIP 假存活。
✅ 推荐三级健康检查策略:
- L3 层:ICMP ping + BFD 链路探测(毫秒级)
- L4 层:对真实服务端口(如 Nginx 的 80/443)做 TCP connect 检查,超时 ≤500ms
-
L7 层:调用
/healthz?deep=1接口,该接口需校验下游 DB、缓存、日志写入、证书有效期等核心依赖 - 所有检查失败需满足「连续 3 次失败才触发切换」,并设置
fall 3/rise 2 - 关键:添加
notify_master/notify_fault脚本,自动触发告警、日志快照、流量镜像分析,便于事后归因
四、基础设施与运维必须匹配高可用等级
再完美的 Keepalived 配置,若运行在单电源、单上联、无异地灾备的服务器上,就不可能达到五个九。
✅ 必须满足:
- 三台网关节点物理分离:不同机柜、不同 PDU、不同接入交换机、不同光缆路由(防光纤被挖断)
- 所有节点 BIOS/固件/内核版本严格一致,避免因 patch 差异导致 VRRP 状态不一致
- Keepalived 配置文件使用 Git + CI/CD 管控,禁止手工修改;每次变更自动触发全链路冒烟测试(含模拟主节点宕机)
- 部署轻量级 Prometheus + Alertmanager,对
keepalived_instance_state、vrrp_advert_int、ip_vs_conn_count等指标做基线告警
真正的 99.999% 不是配置出来的,而是通过冗余设计、可观测性、自动化验证和物理隔离共同保障的。Keepalived 是能力载体,不是银弹。





