





核心是按硬件能力设初始权重并动态调优:以最强机为基准(如weight=10),按cpu核数、内存容量比例折算,nvme ssd可加权0.5~1;需监控cpu、响应时间等指标自动降权,并结合灰度发布、跨az延迟差异等场景主动干预,确保rps与权重比匹配且错误率合理。
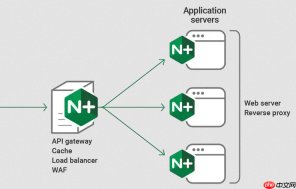
要让不同代际的硬件服务器在集群中平稳运行,核心不是平均分流量,而是让每台机器承担它“真能扛得住”的那份压力。weight 参数就是这个调度杠杆——设得准,新旧机器各司其职;设偏了,旧机卡死、新机闲着,集群反而更脆弱。
按硬件能力定初始权重,不拍脑袋
权重是相对值,关键在比例合理。建议以性能最强的服务器为基准(比如设 weight=10),其余按可量化指标折算:
- CPU 核数比是 16:8:4 → 权重可设为 4:2:1
- 内存容量比是 64GB:32GB:16GB → 同样对应 4:2:1
- 若某台配有 NVMe SSD,I/O 延迟低 40%,可在原权重基础上加 0.5~1(如从 4 调到 4.5)
- 避免用太小的整数(如 1 和 2),推荐统一放大 10 倍(如 10:4:2),降低微小误差对实际流量的影响
用动态反馈防权重失准
静态权重会过时。一台高配服务器 CPU 使用率冲到 90%,它的真实处理余量已远低于标称值,但 weight 还是 10,结果越压越垮。
- 必须监控真实瓶颈:CPU 使用率、平均响应时间、5xx 错误率、连接排队长度
- 设定自动调权规则:例如某节点 CPU > 80% 持续 2 分钟,权重临时降为原值的 50%
- Nginx 自身不支持运行时改 weight,需配合 nginx-upstream-check-module 或外部控制器(如 Consul Template + reload)实现闭环
结合运维节奏做主动干预
weight 不只是均衡工具,更是发布、排障、扩容的运营抓手:
- 灰度上线新版本:新节点 weight=1,老节点 weight=10;观察稳定后阶梯上调(1→3→5→8),同步下调老节点
- 某台机器 iowait 飙高但 CPU 正常?不能只盯 CPU,应单独采集磁盘等待指标,超阈值即临时降权
- 跨可用区部署时,把延迟低的 AZ 权重设高(如 6),延迟高的设低(如 2),再叠加健康检查自动切流
验证是否真解决了倾斜
别只看负载均衡器转发了多少请求,要看后端真实水位:
- 对比各节点 RPS(每秒请求数)与它们的权重比是否接近 —— 若 weight=4/2/1,RPS 应大致呈 4:2:1
- 检查高权重点的平均响应时间是否显著高于低权重点;若是,说明它已过载,权重设高了
- 关注错误率分布:如果某台低权重机器错误率反常升高,可能是配置或网络问题,而非权重本身






