





就在刚刚,claude opus 4.8(high)强势登顶该榜单首位。
RHAE得分为1.5%,是第二名的整整三倍!
但代价同样惊人——单次评测耗资高达1万美元。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
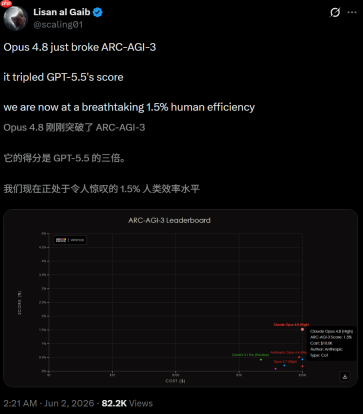
若放在其他主流AI测评中,1.5%这个数字几乎等同于“不及格”。
但在ARC-AGI-3这项测试中,它却是迄今为止的最高分,且毫无争议。
此前的纪录由Opus 4.6(Max)保持,得分为0.5%。
GPT-5.5则仅为0.4%,甚至不足Opus 4.8的三分之一。
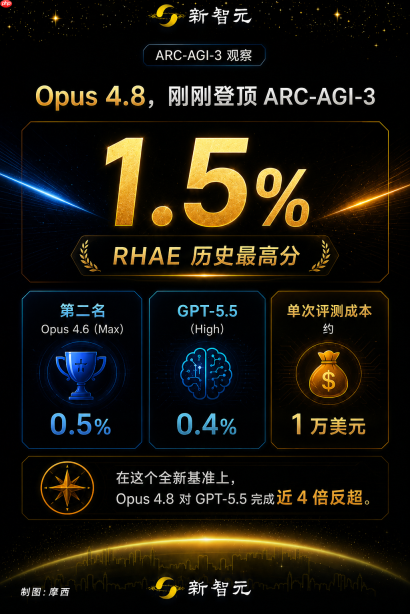
截至6月1日的完整排名如下:
Opus 4.8(High),1.5%,1万美元
Opus 4.6(Max),0.5%,8900美元
GPT-5.5(High),0.4%,1万美元
Gemini 3.1 Pro(Preview),0.4%,2200美元
Opus 4.7(High),0.2%,1万美元
GPT-5.4(High),0.2%,5200美元
Grok 4.20(Beta Reasoning),0.1%,3800美元
Opus 4.8强势登顶,刷新最难AI考试SOTA纪录
最高分仅1.5%。这张试卷究竟难在何处?
尽管此前的ARC-AGI-1与ARC-AGI-2也颇具挑战性,但它们本质仍是带标准答案的填空题。
而ARC-AGI-3则是将模型直接投入一个完全陌生的游戏世界——零说明、零引导、零提示。
一切靠自己摸索规则、推测目标、构建策略、规划路径。
测试一经发布,所有顶尖AI模型的成绩瞬间清零。
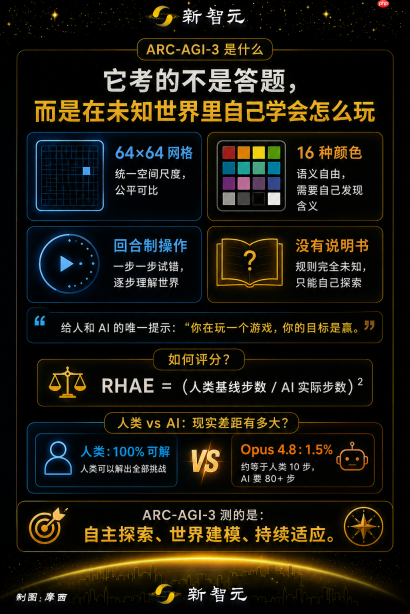
简而言之,ARC-AGI-3真正考察的是Agent级能力。而Opus 4.8此次升级的核心方向,恰恰全部聚焦于此。
在多数传统基准测试中,它的提升幅度相对温和:
SWE-bench Verified从87.6%小幅升至88.6%,GPQA Diamond则稳定在93.6%。
但在所有与Agent能力强相关的评测中,表现却迎来质变式飞跃。
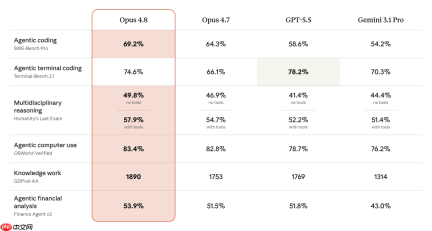
SWE-bench Pro(更具挑战性的代码修复任务)从64.3%跃升至69.2%,大幅领先GPT-5.5的58.6%,优势超10个百分点。
Online-Mind2Web(网页浏览器操作测试)斩获84%准确率,同时超越Opus 4.7与GPT-5.5。
Terminal-Bench Hard则实现6.8个百分点的显著增长。
反观GPT-5.5:
它在静态推理任务上依旧所向披靡——ARC-AGI-2拿下85%,Terminal-Bench各项指标也全面占优。
可一旦任务性质从“解一道题”转向“在动态复杂环境中持续执行与调整”,GPT-5.5便明显力不从心。
SWE-bench Pro落后Opus 4.8逾10个百分点;在更贴近真实工作流的GDPval-AA评测中,Opus 4.8以1890 Elo分领先约120分,胜率达67%。
换言之:若考的是“已知领域内的深度推理”,GPT-5.5仍为王者;若考的是“面对未知场景的实时理解与长期适应”,Opus 4.8正迅速拉开身位。
而ARC-AGI-3,正是后一能力的极致压力测试。
5帧识别规则,随后陷入局部最优陷阱
为深入解析Opus 4.8的实际表现,ARC Prize官方同步公开了其完整解题过程。
核心洞察只有一个关键词——「抽象层级」。
Opus 4.7眼中的ARC-AGI-3画面,是一张像素级图像,依赖底层视觉特征进行逐帧分析。
Opus 4.8看到的,则是可交互的对象与系统结构——它能主动区分实体、背景、动态关系,并建模行为逻辑。
仅差一个抽象层级,结果却判若云泥。
在ar25环境中,Opus 4.8仅用5帧即归纳出镜像反射规律(“蓝色左移3格 → 橙色右移3格……关于第31列对称”),并在24步内通关首关。
在lp85环境中表现更为惊艳。
这是ARC Prize官方认证的Opus 4.8“公开表现最佳环境”,多个关卡达成接近人类水平的操作效率。
但在dc22环境中,它虽顺利通过前3关,却在第4关陷入顽固的错误子目标循环,始终无法跳出。
这恰恰是Opus 4.7根本无法抵达的阶段,也标志着一种全新的失败范式。
进步与新缺陷,同步抵达。
每一代ARC-AGI,都在预演下一场AI主战场
自诞生以来,ARC-AGI每一次迭代,都精准映射了下一阶段AI竞争的核心方向。
ARC-AGI-1预言了推理范式的崛起。
2024年底o3模型的重大突破,正式宣告大推理模型(LRM)时代的开启;半年后,“强推理”已成为前沿模型的标配能力。
ARC-AGI-2预告了编程Agent的爆发。
2025年各大模型在ARC-AGI-2上的快速跃升,与Claude Code、Codex等编程Agent产品的密集落地节奏高度重合。
而ARC-AGI-3正在检验的,是AI在开放交互环境中的自主探索与泛化适应能力。
倘若历史规律再次应验,那么接下来的竞争焦点,将聚焦于——谁能在从未见过的世界里,最快完成认知重建与策略演化。
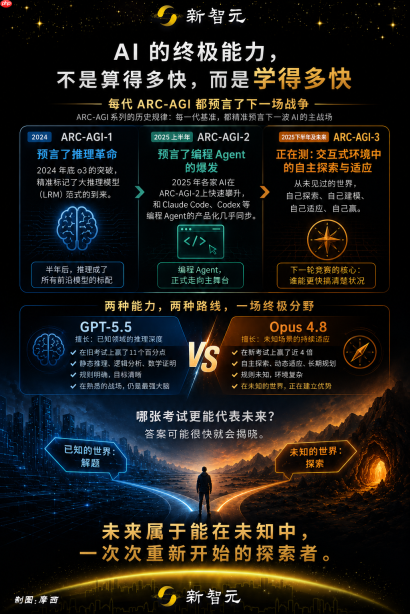
GPT-5.5在旧体系中领先11个百分点;Opus 4.8在新体系中领先近4倍。
哪张考卷更能定义未来?答案或将很快揭晓。
参考资料:
https://www.php.cn/link/b2a789320cd3824071acd43ef60e8304
https://www.php.cn/link/64d0072584e8593e682126fa42306f19
本文来自微信公众号“新智元”,作者:ASI启示录,36氪经授权发布。


