





deepseek 研究员陈德里(deli chen)和 ai 合作的第二篇论文来了!
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文地址:https://victorchen96.github.io/continual_learning_survey.pdf
这篇论文聚焦continual learning(持续学习) 与 self-iteration(自我迭代)。在陈德里看来,这是 AI 迈向 AGI 过程中极为关键的一步。
由于 arXiv 不允许将 AI 列为作者,陈德里这次只能把实际承担了论文 99% 工作量的 DeepSeek-V4-Pro (负责文字)和 GPT-Image-2(负责图像),从作者栏移至脚注说明。
在这篇论文里,陈德里的判断是,未来的 AI 系统不会长期停留在一组冻结参数的形态,而会逐渐演变为能够持续学习、自我更新、自我迭代的系统。
这背后的逻辑也很直接:上下文管理和文档化记忆,确实可以在一定程度上帮助模型维持注意力、保留任务经验。但注意力窗口终究会被填满,到了那个时候,就需要把知识和经验参数化,以降低认知负担。
值得注意的是,这不只是一次论文主题上的延伸,也是陈德里搭建的自主科研智能体框架 DeliAutoResearch SKILL自身的一次迭代实验。
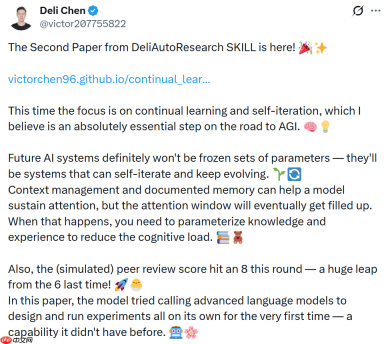
来源:https://x.com/victor207755822/status/2060315686329778432
据陈德里介绍,这一轮模拟同行评审分数达到了 8 分,相比上一篇论文的 6 分有明显提升。更重要的是,在这篇论文的生成过程中,模型首次尝试调用更高级的语言模型,自主设计并运行实验,这也是此前版本尚不具备的能力。
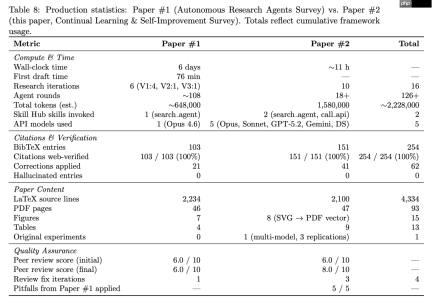
更能体现系统变化的,是论文中披露的生产数据对比。陈德里在第二张图中对比了两篇论文的生成过程:从第一篇到第二篇:随着 SKILL 本身不断迭代,交互轮数大幅下降,而总 token 消耗显著上升,这反而是一个非常好的信号!它说明SKILL 正在向更高自主性转变。
换句话说,人工介入变少了,系统自己想和做的部分变多了。对一个自动科研工作流来说,这恰恰是走向更高自主性的信号。
陈德里表示非常期待在不久的将来,DeliAutoResearch SKILL 能够真正产出大师级的学术写作。
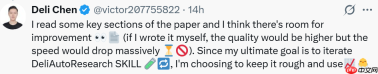
不过,他也坦言,在阅读论文的一些关键部分后,仍能看到不少提升空间。
如果完全由自己亲自撰写,论文质量或许会更高,但产出速度也会大幅下降。由于当前的核心目标并不是打磨单篇论文,而是持续迭代 DeliAutoResearch SKILL 本身,因此他选择保留这篇论文中略显粗糙的部分,将其作为系统继续进化的反馈样本。
下面,我们来看一看,这篇论文讲了什么。
为什么要统一持续学习和自我改进?
论文提到,在传统的研究中,持续学习和自我改进往往被当作两个不同研究方向,但它们面对的是同一个底层问题:模型如何在接收新信息或新目标之后更新自己,同时不破坏已经掌握的能力?
持续学习关注的是模型如何顺序适应新的任务或数据;自我改进关注的是模型如何自主增强能力。但两者的技术难点高度相似:都要在分布变化下稳定优化,都要保留已有表征,都要处理探索与利用之间的权衡,也都要在没有固定测试集的情况下评估进步。
因此,作者认为,下一代 LLM 训练管线必然会把外部数据流和模型自生成训练信号结合起来,形成紧密耦合的反馈循环。也就意味着,统一研究这两个方向不是方便之举,而是必要之举。
核心贡献一:提出了一个三轴统一分类框架
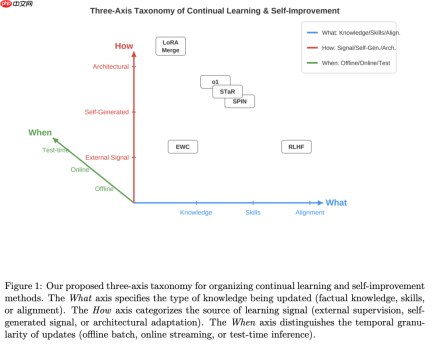
这篇论文最主要的贡献之一是提出了首个同时覆盖大语言模型持续学习与自我改进的分类框架,并将其组织在三个相互正交的维度上:

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
- 更新什么:即被更新的是知识、技能、对齐能力还是推理能力;
- 如何更新:即采用哪一类方法;
- 何时更新:即更新发生在离线阶段、周期性阶段、在线阶段,还是由特定事件触发。
这个三轴框架如下图所示,能够对任何部署后的学习系统进行精确刻画,并揭示不同方法之间此前未被充分认识到的联系。
核心贡献二:对五大方法类别进行了系统分析
论文系统分析了 100 多篇论文,并将其归纳为五类方法:基于正则化的持续学习、回放与经验管理、参数高效与模块化方法、自我改进与自博弈,以及在线自适应方法。对于每一类方法,都形式化描述其核心机制,分析其理论性质,并比较代表性方法。
核心贡献三:形式化刻画了自我改进的收敛条件
论文对迭代式自我改进在什么条件下能够保证收敛而不是发散进行了形式化分析,并将来自自博弈、迭代蒸馏和 Constitutional AI 等研究方向中分散的理论结果,统一到同一个框架之下。
论文认为,自我改进代表了一种范式转变:模型能力提升正在从依赖人类监督,转向由模型自主驱动。所提及的方法覆盖了一个很宽的范围:从训练阶段的自博弈,通过多轮迭代修改模型权重;到推理阶段的推理增强,提升每一次单独预测的质量;再到理论分析,划定自我改进究竟能够达到什么边界……
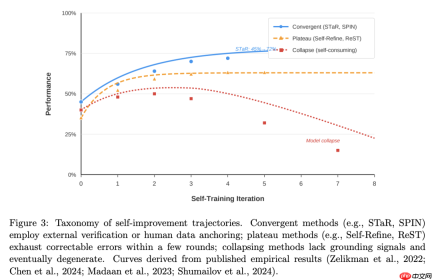
这些方法的共同点在于,它们都需要某种 grounding signal,即可靠的锚定信号。这个信号可以是验证器、一套宪法原则、人类偏好数据,也可以是问题本身的结构。没有这样的锚定信号,自我改进的循环最终必然会退化。
如下图所示,自我改进的轨迹并不取决于生成机制有多复杂,而取决于评估信号的质量,以及它相对于模型自身的独立性。
核心贡献四:提出六个开放挑战
在最后,论文指出了生成式模型持续学习走向成熟过程中,亟待解决的六个关键问题,并基于系统分析所揭示的研究空白,为每个问题提出了未来研究方向。
大模型规模能否解决灾难性遗忘:更大的模型确实可能更不容易遗忘,但规模不是根治方案。随着任务持续增加,即使大模型也会遇到容量、干扰和对齐漂移问题。未来需要研究的是,大模型规模如何影响稳定性 — 可塑性权衡,以及是否存在可预测的 Scaling Law。
自我改进的理论极限:模型能否无限自我提升?什么时候会收敛?什么时候会坍塌?论文认为这是核心理论问题。尤其是在缺少外部验证器的语言任务中,模型很容易陷入自我确认:它会不断强化自己已经相信的模式,而不一定更接近真实目标。
多模态持续学习:未来模型不只处理文本,还会处理图像、音频、视频和行动数据。多模态模型持续学习时,一个模态的更新可能影响另一个模态。例如更新视觉生成能力,可能影响语言理解;更新语言对齐,也可能影响图像生成行为。如何跨模态保留能力,是未来研究中需要解决的难题。
安全的持续对齐:模型持续学习时,安全边界也必须持续保持,可问题在于,任何更新都可能削弱原有对齐能力。因此,论文认为,未来需要「可证明安全」的持续对齐机制:模型变得更强的同时,安全约束不能被遗忘或绕过。
部署时「实时学习」:实时服务要求低延迟和高稳定性,而在线学习需要计算梯度、更新参数、验证质量、避免回归等,这两者「天然冲突」。因此,真实部署中需要设计分层更新机制:哪些变化即时处理?哪些变化延迟批处理?哪些变化必须经过安全审查后才能进入参数?
与 Agent 框架结合:智能体会在长期任务中积累经验,比如工具调用结果、失败教训、用户偏好、环境反馈等。问题是:什么时候把短期经验写入长期记忆?什么时候应该更新参数?哪些经验只是偶然事件,哪些经验代表稳定规律?
论文认为,未来需要层级记忆架构,让 Agent 同时拥有短期情节记忆和长期参数知识,也需要多智能体持续学习机制,让多个 Agent 共享并整合经验。
写在最后
最后,论文的核心判断是:持续学习和自我改进正在走向融合。真正有前景的方向,是构建这样一种模型:它既能吸收外部世界的新知识,也能利用自我反思、自我验证和自我搜索来改进学习策略;既能变得更强,又能保持稳定与安全。
简言之就是,不只是训练得更大,而是能不能在不遗忘、不失控的前提下,持续学习、持续对齐、持续自我进化……
那么你呢,如何看待这篇「AI 写的论文」,欢迎在评论区留言、交流!
参考链接:
https://x.com/victor207755822/status/2060315686329778432
https://victorchen96.github.io/continual_learning_survey.pdf
本文来自微信公众号“机器之心”,作者:关注AI的,36氪经授权发布。



