





least_time算法按connect、header、last_byte三种模式动态选当前响应最短节点:connect测tcp建连,header测ttfb(推荐web api),last_byte测完整响应;需启用keepalive和slow_start,不可与weight混用。
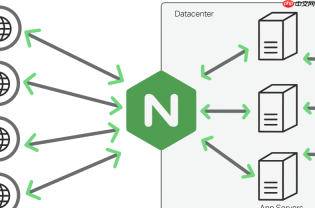
least_time 算法不是选“看起来快”的节点,而是用实测响应时间做实时决策——它持续采集、动态比较、每轮请求都挑当前最快的那个后端。关键不在“快”,而在“你定义的快是什么”。
三种响应时间模式怎么选
least_time 后必须跟一个子参数,它决定了“最快”到底量什么:
- connect:只算 TCP 建连耗时。适合网络不稳定但后端处理很稳的场景(比如纯计算服务),开销最小,但不反映业务处理能力
- header(推荐 Web API):统计到收到响应头为止(即 TTFB)。包含建连 + 请求发送 + 首字节返回,最贴近用户首屏体验。若某台机器 header 很低但 last_byte 波动大,可能说明它响应快但带宽或磁盘慢
- last_byte:统计整个响应体传输完成的时间。适合大文件下载、长轮询、流式接口,能避免后端提前断连导致的误判
基础配置必须满足的硬性条件
least_time 必须写在 upstream 块中,且有两条不可妥协的要求:

- keepalive 必须开启:不启用长连接,每次新建 TCP 连接都会重置计时起点,测出来的响应差异就失真了。建议设为 keepalive 32;
- 新节点要配 slow_start:例如 server 192.168.1.10:8080 slow_start=30s;,防止刚上线时因无历史数据被默认当成“最快”,瞬间压垮
- 不能和 weight 混用:权重会被静默忽略,配置里出现 weight 就等于白写
怎么避免被“假快”误导
响应时间异常低,未必代表健康。比如某节点超时断连,header 可能极快返回 502,但实际没处理完——这时 last_byte 更可靠。
- 日常监控建议接入 Nginx Plus 的 /api/5/upstreams 接口,抓取 response_time_in_seconds 字段趋势
- 若某节点长期 header 耗时显著低于其他节点,但 last_byte 波动剧烈或错误率高,应检查是否丢包、代理截断或后端异常退出
- 突发流量下可加 queue 100 timeout=5s; 缓冲请求,防止所有请求争抢同一个“最快节点”引发雪崩
如何验证调度真的变聪明了
不能只看日志里请求数分布是否均匀,要交叉分析:
- 开启 stub_status,访问 /nginx_status 查看各 server 的 active 连接数是否随压测趋于均衡
- 采集 $upstream_connect_time 和 $upstream_header_time 变量,识别“连接建立快但业务处理慢”的异常节点
- 绘制 active connections vs response time 散点图,定位“连接数低但延迟高”的离群点(常见于内存泄漏、本地缓存失效或磁盘 I/O 阻塞)





