





解决反向代理中time_wait过多的核心是降低生成速率、加快资源周转、避免端口枯竭,需nginx长连接配置与内核参数协同优化,并辅以分流和协议升级。
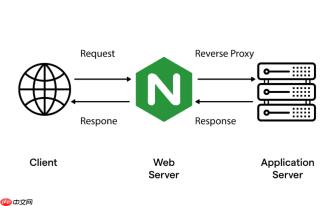
解决反向代理中 TIME_WAIT 过多导致的连接建立时延,核心不是消灭 TIME_WAIT(它本就是协议必需),而是**降低其生成速率、加快资源周转、避免端口枯竭**。关键在于从应用层(Nginx 配置)和系统层(内核参数)双线协同优化,而非只盯一个参数。
让 Nginx 和后端保持长连接
这是最直接、最有效的解法。短连接每处理一次请求就新建+关闭一次 TCP 连接,必然高频触发 TIME_WAIT;而长连接复用已有通道,大幅减少连接创建/销毁次数。
- 在 upstream 块中启用 keepalive,并设置合理数量(如 32 或 64):
upstream backend {
server 10.10.2.3:8080;
keepalive 32;
} - 在 location 中强制使用 HTTP/1.1 并清空 Connection 头,防止客户端干扰:
proxy_http_version 1.1;
proxy_set_header Connection ""; - 确保后端服务(如 Tomcat、Spring Boot)也配置了匹配的 keep-alive 超时,避免单方面维持连接失败
调整内核参数释放端口压力
当长连接无法完全覆盖所有流量(比如存在大量健康检查、异步回调等短连场景),需配合内核调优提升端口复用能力与回收效率:

- 开启时间戳并启用复用:
net.ipv4.tcp_timestamps = 1
net.ipv4.tcp_tw_reuse = 1
注意:tcp_tw_reuse 只对 Nginx 主动发起的 outbound 连接生效,且要求目标四元组(目的 IP + 端口)有变化 - 扩大临时端口范围:
net.ipv4.ip_local_port_range = 1024 65535
将可用端口从默认约 3.2 万个扩展到 6.4 万个,直接提升并发连接上限 - 加快中间状态清理:
net.ipv4.tcp_fin_timeout = 30
缩短 FIN_WAIT_2 等状态等待时间,缓解进入 TIME_WAIT 前的堆积 - 提高 TIME_WAIT 桶容量上限:
net.ipv4.tcp_max_tw_buckets = 200000
防止因桶满触发静默丢包 - 务必禁用 tcp_tw_recycle:
net.ipv4.tcp_tw_recycle = 0
该参数在 NAT、云负载均衡环境下极易引发连接失败,现代内核已移除,但旧配置仍可能残留
确认瓶颈是否真由 TIME_WAIT 引起
别一上来就改参数。先用三行命令快速验证:
- ss -s | grep time-wait —— 看数量是否远超 established(例如 tw: 28000 vs estab: 400)
- cat /proc/sys/net/ipv4/ip_local_port_range —— 默认 32768–65535,仅约 3.2 万可用端口;若 TIME_WAIT 数接近该值,就是瓶颈
- ss -tan state time-wait | head -5 | awk '{print $5}' —— 若目标地址高度集中(如全是 10.10.2.3:8080),说明后端单一,tcp_tw_reuse 将静默失效,此时必须引入多实例或服务发现分散目标
补充策略:分流与协议升级
当单机压力持续逼近极限,需跳出单点优化思维:
- 部署多个 Nginx 实例,通过 DNS 轮询或 SLB 分流请求,天然摊薄每台机器的 TIME_WAIT 压力
- 后端支持 HTTP/2 时,启用 h2 协议。单个 TCP 连接可承载多路请求,进一步压缩连接数
- 对非核心接口(如日志上报、埋点)采用连接池或异步批量发送,避免产生大量零散短连





