






水平扩展的关键在于架构分层、服务发现、流量分发与状态解耦,连接数配置仅是协同环节;需匹配资源限制、复用连接池、结合熔断与动态路由,并依据业务特征优化及监控负载均衡。
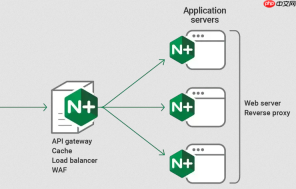
默认连接数策略本身不能直接实现水平扩展,但它会影响单节点的承载能力,进而影响整体集群的扩展效率和资源利用率。真正支撑分布式代理网关水平扩展的是架构分层、服务发现、流量分发与状态解耦——连接数配置只是其中一环,需配合其他机制协同生效。
连接数不是扩展瓶颈,而是调度前提
像Pushpin这类网关,默认client_maxconn=50000,已足够支撑万级并发连接。但若所有连接都压在单个实例上,再高的数值也解决不了单点故障或扩容僵化问题。水平扩展的关键在于:让新增实例能被自动识别、公平分担流量、无需人工调整连接上限。
- 连接数配置应与实例内存、文件描述符限制匹配(如Linux的ulimit -n),避免“设得高却用不上”
- 连接池复用比长连接堆积更重要——HTTP/2多路复用、Keep-Alive超时合理设置,可减少无效连接占用
- 连接数上限应作为熔断阈值参考,而非扩展依据;当某实例连接数持续达90%以上,应触发自动扩实例而非调大数值
依赖服务发现与动态路由才能释放连接潜力
静态配置一堆worker实例并手动分配IP,连接数再高也无法实现弹性伸缩。真正的水平扩展需要网关具备感知后端变化的能力:
- SocketCluster中,scc-state负责广播新scc-worker上线事件,scc-broker据此重平衡Pub/Sub通道,使新增连接自然分流
- API网关(如fiGate)集成Consul或Nacos,通过健康检查自动剔除失联节点,新连接只打向存活实例
- 反向代理层(如Nginx+Upstream)配合Kubernetes Endpoints或Service Mesh的Sidecar,实现连接请求的秒级重路由
连接管理必须与业务流量特征对齐
不同场景下,连接行为差异极大,统一设高连接数反而可能掩盖问题:
- AI代理网关(如openclaw-claude-proxy)面对的是短连接+高Token消耗型请求,重点在请求频次限流和Token配额,而非维持大量空闲连接
- 时序数据接入网关(如TDengine接入层)常有海量长连接保活,需优化TCP keepalive参数和连接空闲回收策略
- WebSocket网关需关注连接生命周期管理,避免因心跳缺失导致连接堆积,此时连接数上限要配合超时自动清理逻辑
监控连接分布比调参更重要
水平扩展是否有效,不看单机最大连接数,而要看全集群连接负载是否均衡:
- 采集每个网关实例的活跃连接数、平均响应时间、错误率,用Prometheus+Grafana构建热力图
- 发现某节点连接数突增但RT未升高 → 可能是流量倾斜,检查DNS轮询或Ingress权重配置
- 发现多个节点连接数长期低于30%,但总吞吐已达瓶颈 → 应排查后端服务延迟或序列化开销,而非盲目加实例





