





5月11日,面壁智能携手清华大学及 openbmb 开源社区,正式推出全新一代端侧多模态大模型 minicpm-v4.6。该模型仅含1.3b参数,以极高的“智能密度”与卓越的跨平台兼容性,在轻量化前提下突破性能边界,显著推动端侧ai规模化落地进程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
一、性能突破:1.3B 参数实现“跨级超越”
MiniCPM-V4.6提供 Instruct 与 Thinking 两大版本,在多项权威评测中展现出远超同规模模型的认知与推理能力:
- 全球领先: 在 Artificial Analysis(AA)榜单上,MiniCPM-V4.6斩获 13分 高分,大幅超越同体量竞品(如阿里 Qwen3.5-0.8B、谷歌 Gemma4-E2B-it),性能逼近参数量翻倍的 Qwen3.5-2B,稳居1B级模型性能榜首。
- 全能表现: 在通用图文理解、STEM领域复杂数理推演、高难度文档OCR识别及视频时序建模等任务中均达行业先进水平;尤其在多图联合推理与幻觉抑制方面,Thinking 版本优势突出。
二、效率跃升:端侧部署的“高密低耗”新范式
为应对终端设备资源受限难题,MiniCPM-V4.6在运行效率与内存占用层面完成关键优化:

One API key for 70+ AI models. Route to GPT, Claude, Gemini, Qwen, Deepseek, Grok and more
下载
统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
- 轻量门槛: 最低仅需 6GB 运行内存,全面适配主流智能手机、PC及IoT智能终端。
- 极速响应: 基于 vLLM 的推理吞吐率达竞品1.5倍;处理3136²超高清图像时,首帧延迟低至 75.7ms,速度提升达2.2倍。
- 强劲吞吐: 单卡即可达成7013 token/s 的文本生成速率,同时支持54.79张/秒(1344²分辨率)的图像处理能力,端侧效能表现极为亮眼。
三、技术底座:LLaVA-UHD v4驱动极致精简
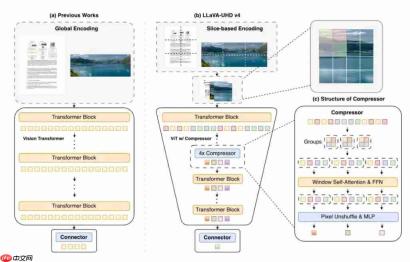
模型得以“小而强”,核心依托面壁智能与清华大学联合研发的 LLaVA-UHD v4 架构:
- 编码革新: 重构ViT图像编码器并引入浅层压缩模块,图像编码开销降低 50%,高分辨率浮点计算量减少 55.8%。
- 弹性压缩: 首创4倍/16倍混合Token压缩机制,支持模型在“精度优先”与“速度优先”模式间动态切换;该技术已在快手OneRec推荐大模型中大规模验证,稳定承载亿级日活流量。
四、生态协同:从开源代码到真实场景
MiniCPM-V4.6的全面开源,标志着端侧多模态AI正加速迈入产业化快车道:
- 开发友好: 深度兼容 ms-swift、LLaMA-Factory 等主流微调框架,开发者仅需单张 RTX4090 显卡即可完成全参数微调。
- 全栈支持: 兼容 vLLM、Ollama 等主流推理引擎,并已发布 iOS、Android、HarmonyOS 多平台测试版本,助力AI能力无缝延伸至各类终端形态。
- 产业落地: 当前已在智能汽车、PC终端、智能家居、工业质检等多个垂直领域实现商用部署,合作企业涵盖联想、吉利、上汽大众、小米、OPPO 等头部科技与制造厂商。
随着 MiniCPM-V4.6 的全面开源,端侧多模态大模型的技术门槛已被实质性打破。未来,AI将不再局限于云端中心化算力,而是深度嵌入每一台终端设备,成为用户身边实时响应、持续进化的“随身智慧中枢”。


