





keepalived vip漂移导致长连接闪断,根本原因是tcp连接状态无法跨节点迁移,叠加arp缓存未更新、vrrp切换延迟及缺乏客户端重连机制;需优化garp刷新、调低advert_int、启用tcp keepalive与客户端重试。
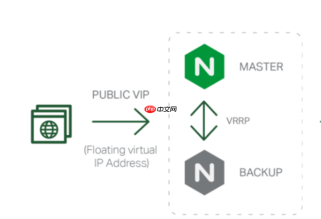
Keepalived VIP漂移引发长连接闪断,核心矛盾不在VIP本身是否绑定成功,而在于TCP连接状态无法随IP归属同步迁移。Linux内核不支持连接状态在节点间热迁移,一旦VIP从原Master摘除,所有已建立的TCP会话即刻失效——客户端发包仍指向旧MAC,服务端收不到ACK,重传超时后连接中断。这不是配置错误,而是VRRP协议固有局限。
确保GARP广播及时且可达
长连接闪断最常见原因是下游设备(交换机、网关、客户端)ARP缓存未更新,导致新请求持续发往已下线节点。
- 在
vrrp_instance块中强制启用多次GARP刷新:garp_master_refresh 5garp_master_refresh_repeat 5 - 配合notify_master脚本,在VIP真正生效后立即触发arping:
notify_master "/usr/bin/arping -c 5 -A -I eth0 192.168.100.100" - 检查交换机ARP老化时间,若大于10秒,需手动清除或缩短至5秒以内
调低VRRP检测与切换延迟
默认1秒通告间隔+3秒超时,意味着最长4秒才触发切换,期间新连接失败,已有长连接因无响应逐步超时。
- 将
advert_int设为0.5,BACKUP节点fail_check设为2次失联即升主 - 禁用抢占模式(
nopreempt)仅用于稳定场景;若需快速回切,启用preempt_delay 2避免抖动 - 确保两节点
virtual_router_id完全一致,且priority差值≥20(如150 vs 130)
绕过连接中断的客户端适配策略
服务端无法“延续”连接,只能让客户端更快感知失败并重建,降低业务影响。
- 应用层启用TCP keepalive(
SO_KEEPALIVE),设置tcp_keepidle=30、tcp_keepintvl=10、tcp_keepcnt=3,约60秒内发现断连 - HTTP服务配置短连接:Nginx加
keepalive_timeout 15s,避免长连接堆积在故障节点 - 客户端SDK集成重试逻辑,对502/504/连接拒绝等错误自动发起幂等重试(建议带100–500ms随机退避)
验证与可观测性加固
仅看VIP是否绑定,无法反映真实连接可用性。必须监控切换瞬间的端到端行为。
- 在客户端侧部署轻量探测:每5秒
curl -m 3 -s -o /dev/null -w "%{http_code}\n" http://VIP/api/health - 抓包确认切换时刻VRRP报文、GARP帧、首个SYN是否抵达新Master:
tcpdump -i eth0 -nn "host VIP and (tcp or arp or proto 112)" - 检查新Master内核连接跟踪表是否接收新连接:
ss -tn state established '( dst VIP )' | wc -l





