





用weight优化异构服务器吞吐配比,核心是按实测稳态qps(如1800:600→3:1)设整数权重,结合nvme等硬件加权微调;须正确配置upstream位置与proxy_pass格式,叠加max_fails健康检查及cpu/p95自动降权机制,并通过prometheus验证实际分流占比。
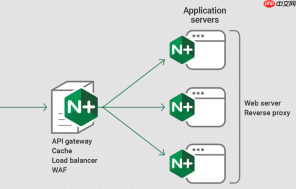
用 weight 优化异构服务器吞吐配比,核心是让流量比例贴合真实处理能力——不是按“配置高就多分”,而是看“此刻能稳扛多少”。静态设数只是起点,关键在测得准、配得稳、调得活。
按实测吞吐反推权重,别只看CPU核数
硬件参数(如16核 vs 4核)可作初始参考,但真正决定吞吐的是业务压测结果。推荐用 wrk 或 ab 对每台后端单独压测,在P95延迟不明显上升、CPU稳定在75%以下时记录QPS:
- 若 A 机稳态承载 1800 QPS,B 机为 600 QPS,初步权重比就是 3:1(如 weight=9 和 weight=3)
- 若某台配 NVMe 且 I/O 延迟低 40%,可在基础值上加 1~2 点(如从 3→4),但避免小数,保持整数易维护
- 统一放大权重值(如 3:1 → 30:10),能降低微小配置误差对实际分流的影响
配置必须写对位置,否则权重完全失效
weight 只在特定上下文中起作用,错一处就退化为普通轮询:
- upstream 块必须定义在 http{} 内、所有 server{} 块之外,不能嵌套在 location 或 server 里
- proxy_pass 必须写成 http://upstream_name,写成 IP 地址或漏掉 http:// 前缀,weight 就不参与调度
- 未声明 weight 的节点默认为 1;weight=0 表示临时下线,不参与任何请求分发
光靠 weight 不行,必须叠加健康反馈机制
weight 是静态概率,不感知实时负载。一台 weight=10 的机器若 CPU 已满、响应变慢,继续猛灌只会雪崩:
- 每个 server 行建议加上 max_fails=2 fail_timeout=30s,连续失败即隔离,避免请求打到假死节点
- 对高权重主力机,可设更宽松的容错(如 max_fails=3 fail_timeout=45s),备用机则更敏感
- 真正防失准,需外部闭环:采集各节点 CPU 使用率、P95 响应时间,超阈值(如 CPU > 80% 持续 2 分钟)自动触发权重下调(需配合 nginx-upstream-check-module 或 Consul Template reload)
上线后验证真实配比,不只看配置
配置正确 ≠ 流量达标。必须通过可观测手段确认实际分流是否符合预期:
- 用 nginx -T | grep -A 5 "upstream" 确认配置已加载,无语法错误
- 启用 stub_status 或接入 nginx-exporter + Prometheus,查各 upstream server 的 requests 计数,算出实际占比(如 weight=4/2/1,RPS 应接近 4:2:1)
- 对比高权重点的平均响应时间是否显著高于低权重点——若是,说明它实际已过载,权重设高了,该调低





