





Mega-ASR是什么
mega-asr 是南洋理工大学(ntu)、新加坡国立大学(nus)与上海人工智能实验室联合开源的全场景鲁棒语音识别基座模型,模型以 qwen3-asr 1.7b 为底层架构,针对真实世界中复杂声学环境(如噪音、远场、回声、遮挡、传输丢包等复合场景)下的语音识别难题,提出了可扩展的复合数据构建与渐进式声学到语义优化框架。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
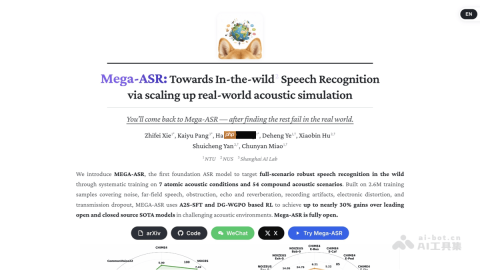

Mega-ASR的主要功能
- 全场景鲁棒语音识别:覆盖 7 种原子声学效应(噪音、远场、遮挡、回声混响、录音染色、电子失真、传输丢包)及 54 种物理合理的复合声学场景,实现单一模型应对多种真实环境。
- 渐进式声学到语义优化(A2S-SFT):三阶段渐进训练,先训练编码器与对齐器适应中等退化语音(WER
- 双粒度动态奖励优化(DG-WGPO):针对 WER>30% 时模型错误模式从”词级混淆”突变为”句级幻觉/丢句”的问题,引入 Token 级精修奖励与句子级重构奖励,通过 WER 门控动态融合,强化极端条件下的语义保持能力。
- 环境感知即插即用路由:内置轻量级音频质量分类器(单层 Transformer),自动判断输入音频为”干净”或”退化”状态,干净语音走原始 Qwen3-ASR backbone,退化语音走 Mega-ASR 鲁棒 LoRA 分支,实现零侵入式增强。
- 开源数据集 Voices-in-the-Wild-2M:发布包含 240 万条合成音频及 5,000 条评测音频(含 1,500 条真实录音)的大规模鲁棒 ASR 数据集,覆盖 7 大元场景与 54 种混合场景,难度分布经过可控实验校准。
Mega-ASR的技术原理
- Voices-in-the-Wild-2M 数据构建:采用频谱级代码仿真,先独立模拟 7 种原子声学效应作为基础,再通过智能体验证物理合理性(如”教堂=远场+回声”),组合生成 54 种复合场景;通过统一严重程度参数 k∈[0,1] 控制难度分布,并剔除 WER>70% 的不稳定样本。
- A2S-SFT 三阶段训练:第一阶段仅训练音频编码器与对齐器,按 WER
- DG-WGPO 动态奖励机制:静态奖励由 WER 奖励与反重复惩罚组成;动态奖励核心包含 Token 级精修奖励(区分软/硬替换错误)和句子级重构奖励(基于最长公共子序列与长度惩罚),通过 WER 门控(阈值 τ=0.3)镜像融合,低 WER 时侧重局部精修,高 WER 时侧重整体语义保持。
- 环境感知路由模型:基于 80 维 log-Mel 特征,采用轻量级卷积前端 + 单层 Transformer 编码器 + 注意力池化结构,二分类准确率超过 99.5%,推理开销极低,实现清洁/退化语音的自动分流。
如何使用Mega-ASR
- 环境准备与依赖安装:基于 Qwen3-ASR 开源生态搭建运行环境,安装相关音频处理库及模型推理依赖(如 transformers、torchaudio 等),确保支持 80 维 log-Mel 谱特征提取与模型权重加载。
- 加载双模型权重:同时加载两个组件,原始 Qwen3-ASR 1.7B backbone 作为基座模型,以及 Mega-ASR 的鲁棒性 LoRA 权重;另外需加载轻量级环境感知路由模型(单层 Transformer,隐藏维度 128,基于 LoRA 微调)。
- 音频预处理后送入路由模型:对输入音频提取 80 维 log-Mel 谱特征,经过轻量级卷积前端编码后,送入路由模型的单层 Transformer 进行二分类判断,自动识别当前音频属于”干净语音”还是”退化语音”(准确率超 99.5%)。
- 自动分流推理:路由模型判定为干净语音时,直接调用原始 Qwen3-ASR backbone 进行标准识别,保证 LibriSpeech 等干净域性能不受损;判定为退化语音时,自动切换至 Mega-ASR 鲁棒 LoRA 分支,激活复合声学场景下的强抗噪与语义恢复能力。
- 获取识别结果:模型输出文本转写结果,在极端退化场景(如远场峰值 -5.2dB、NOIZEUS 0dB)下仍能避免空白输出或语义幻觉,保持高完整度的语音识别结果。
Mega-ASR的核心优势
- 复合场景性能领先:在 Voices-in-the-Wild-Bench 混合退化场景下,WER 达到 2.73/4.57,相对 Whisper-Large-v3 降低 65.8%/69.1%,相对 Gemini-3-Flash 降低 65.8%;在 NOIZEUS 0dB 极端条件下,WER 降至 19.80,相对 Qwen3-ASR 降低 17.4%,相对 Gemini-3-Flash 降低 64.5%。
- 语义恢复能力突出:在远场峰值 -5.2dB 的极端案例中,Qwen3-ASR 输出空白(WER 100%),Gemini-3-Pro 产生流畅但无关的幻觉内容(WER 86.1%),而 Mega-ASR 精确恢复参考文本(WER 0.0%)。
- 干净域性能无损:通过环境感知路由,LibriSpeech 等干净基准 WER 从 1.78/3.57 进一步优化至 1.63/3.37,热词识别、流式推理等原有能力不受影响。
- 训练稳定性高:数据集构建过程中过滤 WER>70% 的不可学习样本,A2S-SFT 采用课程学习策略逐步扩展难度,避免模型在极端退化条件下训练崩溃。
- 完全开源可复现:模型权重、训练代码、数据集构建流程及评测基准均开源,基于成熟的 Qwen3-ASR 生态,社区接入门槛低。
Mega-ASR的项目地址
- 项目主页:http://xzf-thu.github.io/Mega-ASR/
- GitHub仓库:http://github.com/xzf-thu/Mega-ASR
- Hugging Face 模型库:http://huggingface.co/zhifeixie/Mega-ASR
- arXiv技术论文:http://arxiv.org/pdf/2605.19833
Mega-ASR的同类竞品对比
| 对比维度 | Mega-ASR | Whisper Large-v3 | Qwen3-ASR 1.7B | Gemini-3-Flash |
|---|---|---|---|---|
| 开源状态 | 完全开源 | 完全开源 | 完全开源 | 闭源 |
| 底层架构 | Qwen3-ASR 1.7B | Whisper | Qwen3-ASR 1.7B | Gemini |
| 复合场景覆盖 | 7种原子+54种复合 | 有限 | 有限 | 有限 |
| NOIZEUS 0dB WER | 19.80 | ~55.78 | 23.97 | 55.78 |
| VOiCES R4-B-F WER | 45.69% | ~60%+ | 54.01% | ~50%+ |
| 干净语音性能 | 1.63/3.37 (LibriSpeech) | 1.78/3.53 | 1.78/3.57 | 1.52/3.29 |
| 语义恢复能力 | 强(极端条件下WER可降至0%) | 弱(易丢句/幻觉) | 中等 | 弱(易产生幻觉) |
| 即插即用增强 | 支持(环境感知路由) | 不支持 | 不支持 | 不支持 |
Mega-ASR的应用场景
- 车载语音交互:应对发动机噪音、风噪、多人交谈等复合声学环境,提升导航与指令识别准确率。
- 远场会议/课堂转写:解决会议室回声、距离衰减、设备录音染色等问题,实现高质量自动纪要。
- 户外采访与直播字幕:在街道噪音、风声、遮挡等恶劣条件下保持字幕生成的完整性与准确性。
- 智能家居语音控制:提升远距离、多房间混响环境下的唤醒词与指令识别鲁棒性。
- 电话客服与 VoIP 通话分析:针对传输丢包、码率压缩、电子失真等信道退化问题,保障通话内容识别质量。


