





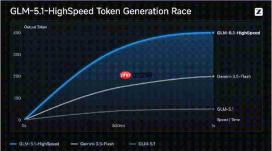
智谱今日正式向部分企业客户推出
此举突破了业内长期存在的固有认知——即“高性能模型必然伴随高延迟”,或“低延迟模型只能是能力受限的轻量级版本”。GLM-5.1高速版首次在国产大模型体系中,将旗舰级语言理解与生成能力与毫秒级响应体验深度融合,真正实现高质量与高时效的同步落地,用户无需再于“效果”与“速度”之间做取舍。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
重构交互范式,赋能强时效性场景
在长周期任务与高复杂度生产流程中,响应速度的跃升正催生新一代AI应用形态:
- 智能编程助手(Coding Agent):在全面继承 GLM-5.1 原生推理深度与代码逻辑严谨性的前提下,新版本支持“所问即所得”的即时反馈。模型可边解析多文件工程上下文,边流式生成代码、补丁及重构建议;面对需数十轮迭代的大型重构任务,彻底消除传统方案中累计数分钟的等待空窗。
- 实时三维建模交互:在3D地图真实测试环境中,用户操控角色移动并输入自然语言指令,模型可在毫秒级完成语义解析与几何建模,并同步驱动场景动态更新。
- Agent集群协同调度:在复杂网页分析类长程任务中,单次请求30秒内即可完成端到端处理;更可瞬时激活并协调50个差异化人格Agent并行响应,初步展现出具备自主调度能力的AI操作系统雏形。
技术内核解析:TileRT 超低延迟推理引擎
达成400 TPS稳定吞吐的核心,在于智谱 GLM 研发团队与 TileRT 工程团队联合打造的全栈式推理加速架构:
-
推理引擎层(TileRT 编译期 AOT 静态融合):
主流框架通常以算子(operator/kernel)为最小调度单元,在单 token 或小 batch 场景下易引发频繁调度、内存访存与同步开销。TileRT 彻底摒弃运行时(Runtime)动态调度机制,转而在编译阶段(AOT)将完整计算图静态编排为一个驻留 GPU 的persistent Engine Kernel。在单卡内,计算、异步IO与跨核通信被细粒度切分为 Tile 级微任务,整次推理仅需一次 Kernel Launch,中间结果全程通过寄存器、Shared Memory 和 L2 Cache 直接流转,完全规避全局显存写回。 -
调度系统层:
引入自适应动态批处理、请求聚合机制及精细化 KV 缓存生命周期管理,在高并发请求洪峰下显著压降尾部延迟(p99+)。 -
基础设施层:
将 GPU SM 单元内的Warp Specialization设计思想扩展至整套8卡 NVL互连拓扑,依据各 GPU Rank 的计算负载密度与数据依赖关系,将其特化为功能各异的专用 Worker 节点,并协同优化网络带宽分配与负载均衡策略,保障超高速服务的持续稳定输出。
开放节奏与接入方式
GLM-5.1高速版特别适配对响应延迟极度敏感的业务场景,包括但不限于 AI 编程辅助、实时人机交互、高频商业决策支持以及实时语音合成与理解等。目前该能力已正式上线
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!


