





过去十年,智能手机行业的竞争焦点已历经多轮更迭。
最初比拼的是屏幕素质与外观工艺,随后转向SoC性能的全面较量;紧接着,影像能力跃升为高端旗舰的核心竞争力,而近两年,续航体验与快充技术则接棒成为用户体验升级的关键抓手。如今,当影像系统迈入“一英寸大底”新阶段、电池容量突破10000mAh之后,整个行业正迫切寻求下一个结构性突破点。
智能手机
与此同时,AI正深度重塑智能手机的本质。在这场新一轮技术博弈中,一项原本专属于AI服务器与高端GPU领域的关键技术,正加速进入主流手机厂商的研发视野——HBM(High Bandwidth Memory,高带宽内存)。
近期消息显示,三星正秘密推进面向智能手机及平板设备的移动级HBM封装方案,旨在将原本服务于数据中心的HBM技术,逐步“下沉”至消费级终端。这一动向之所以引发广泛关注,并非仅因其技术前瞻性,更在于它释放出一个明确信号:智能手机或将迎来一场以“内存架构”为核心的范式变革。
如果说上一个时代比拼的是“算力密度”,那么下一个时代决胜的关键,或将转向“数据吞吐效率”。而HBM,正是撬动AI手机性能天花板的关键支点。
AI时代下,LPDDR正逼近物理极限
长期以来,LPDDR系列一直是移动端主流内存标准。从LPDDR4、LPDDR5到LPDDR5X,其演进路径始终聚焦于提升频率与降低功耗两大维度。
这套设计逻辑在传统移动应用生态中表现优异——无论是APP冷启动、高清视频解码,还是主流手游运行,均属于典型的“瞬时高负载”场景,对持续性数据带宽的压力相对有限。
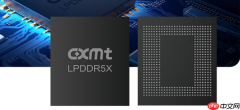
LPDDR5X
但在AI原生时代,情况发生根本性转变。当终端开始本地部署大语言模型、实时生成多模态内容、执行端侧语音语义联合推理时,系统内部的数据交互规模呈指数级膨胀。模型参数量持续攀升,NPU/GPU需高频次访问海量权重数据,内存带宽瓶颈日益凸显,连带引发功耗激增与热管理压力陡升。
简言之,芯片端侧AI算力已不再是唯一制约因素,“内存带宽”正悄然取代算力,成为制约AI体验落地的新一代性能墙。
这也解释了为何全球半导体产业链正集体重估HBM价值。相较于传统LPDDR,HBM的核心优势不在于容量大小,而在于极致带宽。LPDDR5X通常采用64位总线宽度,而HBM凭借1024位超宽总线,叠加3D堆叠与TSV硅通孔技术,理论数据吞吐能力可达TB/s量级。
这意味着AI模型在调用参数时,无需长时间等待数据“搬运”,响应延迟大幅压缩。对手机而言,这种能力尤为关键——端侧AI真正依赖的并非单纯CPU主频,而是海量数据能否在毫秒级完成调度与交换。
HBM为何长期缺席移动终端?
事实上,HBM并非新兴技术,它早已在AI训练服务器、高性能计算集群及顶级显卡中成熟应用多年。英伟达旗舰GPU之所以能高效支撑百亿级参数模型训练,HBM正是其底层带宽基石。
但此前它始终未能登陆智能手机,核心症结只有一个词:成本过高。
LPDDR采用平面化封装方式,而HBM则通过TSV工艺实现DRAM芯片的垂直堆叠,并借助中介层与处理器直连。这种立体集成结构带来三重显著优势:
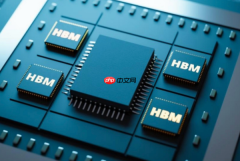
存储心片
超高带宽:HBM3E实测带宽已达1.2TB/s,相较LPDDR5X提升数倍;
超低延迟:数据传输路径大幅缩短,访问效率跃升;
更高能效比:单位带宽下的功耗控制更优。
然而代价同样突出:TSV制程、3D堆叠精度、先进封装工艺、中介层设计等环节,无一不是制造难点。尤其在手机这类空间极度受限、散热能力薄弱、功耗预算严苛、成本敏感度极高的终端中,HBM的工程适配难度远超服务器场景。因此,过去它只存在于单价数万元的专业计算设备中,而非大众消费级手机。
直到端侧AI成为刚性需求,HBM才真正被推上移动终端的议事日程。
三星为何率先破局?
三星的布局,本质上折射出产业界对“端侧AI落地能力”的深层焦虑。未来AI体验的竞争焦点,或将从“是否具备AI功能”,转向“能否在本地运行更大、更复杂的模型”。
云端AI虽强大,却存在固有短板:网络延迟不可控、用户隐私难保障、持续联网依赖强、推理服务成本高。因此,将AI计算能力前移至终端,已成为行业共识。而一旦AI算力回归手机本体,整套硬件架构就必须随之重构。
三星
据多方信息显示,三星此次攻关的重点,并非简单复刻服务器级HBM,而是打造一套专为移动设备定制的新型封装体系。其技术路径包括超高纵横比铜柱互连、FOWLP扇出型晶圆级封装,以及优化后的VCS垂直铜柱堆栈结构,目标是在极小空间内构建更多并行数据通道。
例如,三星已将铜柱纵横比从常规的3–5:1大幅提升至15–20:1,以在单位面积内实现更高密度的数据连接。这背后,实则是一场围绕“物理空间”的激烈争夺战——影像模组持续膨胀、电池厚度不断加码、散热系统日趋复杂、AI协处理器面积持续扩张……若HBM无法在体积与功耗上实现突破,就注定难以真正嵌入手机主板。
换言之,三星正在做的,不只是把HBM“搬进”手机,而是在重新定义移动内存的物理形态与集成逻辑。
苹果与华为为何同步跟进?
三星并非孤例。苹果与华为也被广泛认为已在HBM领域展开实质性布局。
业内普遍预期,苹果或将在2027年——iPhone问世二十周年之际——正式引入移动HBM。作为Apple Intelligence战略的核心载体,iPhone正加速构建端侧AI闭环。相比依赖云端的路线,苹果更强调本地隐私保护、本地计算执行与本地推理响应,这对数据吞吐能力提出了更高要求。不过,受限于其一贯极致轻薄的设计哲学,HBM带来的散热挑战极为严峻,因此苹果更可能选择高度定制化的整合方案。
iPhone效果图
相较之下,华为反而更具率先商用HBM的现实条件。近年来,华为在端侧AI层面动作密集,鸿蒙AI生态与智能体(Agent)架构均对底层数据调度能力提出更高诉求。此外,折叠屏机型天然拥有更充裕的内部堆叠空间,也为HBM这类新型器件提供了理想的验证平台。业内已有多个信源指出,华为极有可能在下一代折叠旗舰中试点移动HBM,从当前产业节奏判断,这一可能性不容低估。
真正的拦路虎:成本与量产稳定性
尽管前景广阔,HBM短期内仍难实现大规模普及。当前HBM模组的制造成本约为LPDDR的3至5倍,而手机行业恰恰是全球成本管控最严苛的消费电子领域之一。影像系统、屏幕模组、卫星通信模块、AI专用芯片、复合散热结构……每一项都在持续挤压整机利润空间,若再叠加HBM,BOM成本压力将进一步加剧。
手机涨价
此外,良率仍是关键瓶颈。TSV与3D堆叠工艺复杂度极高,公开数据显示,当前先进HBM方案的量产良率仍面临不小挑战。而手机市场对供应链稳定性的要求,远高于服务器市场——毕竟单款机型年出货量动辄千万级,容错率极低。
因此,即便三星、SK海力士等头部厂商已启动移动HBM研发,业界普遍预计,其真正走向规模化商用仍需数年时间。最可能的落地路径是:先切入超高端旗舰机型,待工艺成熟、成本下降后,再逐步向中高端市场渗透。这一节奏,与当年潜望式长焦镜头、一英寸影像传感器的普及路径高度一致。
结语
过去几年,手机厂商反复强调AI算力指标。但当AI真正驶入深水区,行业逐渐意识到:算力≠体验。AI系统的本质瓶颈,终将归结为数据能否被即时、高效地调度与处理。从这个视角看,HBM的战略意义,丝毫不逊于CPU或GPU。
更深远的影响在于,HBM所代表的,是手机产业底层逻辑的又一次跃迁——它曾是“通信工具”,继而成为“移动互联网入口”,而未来,它或将进化为真正意义上的“个人AI计算终端”。
当三星、苹果、华为三大巨头几乎在同一时间将目光投向同一项技术时,它往往已不只是实验室里的概念,而是即将改写产业规则的序章。HBM或许不会立刻颠覆当下市场,但它,很可能锚定未来十年AI手机的能力边界。






