





顶尖的人工智能不仅需要理解屏幕上跃动的当代代码,还应能破译三千年前龟甲上镌刻的古老印记。据oschina报道,腾讯混元大模型、ssv数字文化实验室联合多家高校及故宫博物院,正式发布“chronicles-ocr”。这是业内首个全面涵盖汉字“七体之变”完整演化路径的中国古文字视觉感知评测基准。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
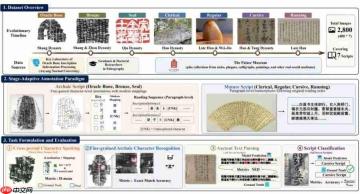
为真实反映大模型在古文字识别中的实际能力,该数据集由多位领域专家开展多轮交叉标注,共收录2800张严格平衡、高保真度的图像样本。针对甲骨文、金文、篆书等早期字体,团队采用单字粒度的精细化标注;而对于隶书、楷书、行书、草书等成熟书体,则采用保持原始书写顺序的序列级转录方式。
主流视觉模型集体失准
研究团队围绕该基准构建了四个由浅入深的核心评测任务,明确分离“视觉感知”与“语义推理”两个关键能力维度。在对GPT-5、Gemini 3.1 Pro、Claude Opus 4.7等28个当前主流多模态大语言模型进行系统测试后,结果令人震惊。

当面对无现代排版规律可循的远古字体时,所有主流模型在端到端检测任务中均未达有效识别水平,细粒度识别准确率最高仅为27.1%。更值得关注的是,实验显示:启用大模型内置的推理(Reasoning)功能后,其感知不确定性反而加剧,识别性能进一步下滑。
暴露笔画层级识别能力缺陷
评测还揭示出另一关键问题:当前视觉大模型在字体判别过程中,更倾向于依赖载体表面的纹理、材质等低阶视觉线索,而非聚焦于决定书体本质的微观笔画形态与运笔特征。这表明,即便站在AI技术最前沿,现有模型在真正意义上“理解”中国传统古文字方面,仍存在显著断层。
从殷墟甲骨上的契刻痕迹,到今日屏幕中的数字字形,汉字每一笔一划都凝结着中华文明绵延不绝的历史脉络。Chronicles-OCR的开源,并非回避技术短板,而是以可量化的差距为镜,清晰指明视觉大模型未来演进的方向——从机械“识字”,迈向深度“读史”。


