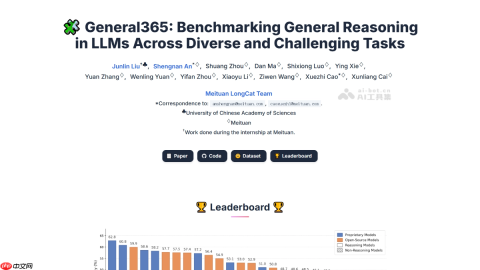
general365 是美团 longcat 团队推出的开源通用逻辑推理能力评测基准,涵盖 365 道人工原创种子题与 1095 个系统生成的扩展变体,全面覆盖八大核心推理挑战类型。该基准严格限定所需背景知识为 k-12 教育水平,剥离学科专业知识干扰,专注衡量大模型在真实日常场景中独立运用逻辑进行分析、推演与决策的能力。实际评测表明,在参与测试的 26 款主流大语言模型中,表现最优的 gemini 3 pro 仅取得 62.8% 的准确率,其余绝大多数模型均未能跨越 60% 这一基础及格门槛。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

qwen-omni-multimodal
下载
基于阿里云百炼 Qwen3.5-Omni 的全模态技能,支持文本、图片、音频、视频理解与文本/语音输出。适用于图片分析、音频转写理解、视频理解、跨模态问答及语音回复生成。
General365的主要功能
- 高维度多样性评测:依托 365 道原创种子题与 1095 个语义/逻辑层面充分变异的题目,精准覆盖复杂约束处理、分支穷举与边界覆盖、时空动态推演、递归假设验证、语义陷阱识别、隐式线索整合、多目标最优路径规划、不完全信息下的概率判断等八大推理难点。
- 推理能力与知识储备解耦:所有题目设计均规避大学及以上层级知识依赖,确保评测结果反映的是纯粹的逻辑结构建模与推理能力,而非记忆性知识调用。
- 双轨混合评分机制:对数值类题目采用 math-verify 工具自动校验;对开放文本与选择题则引入 GPT-4.1 作为辅助评分模型,并经人工抽检验证,整体评分准确率达 99.6%。
- 分阶段数据开放策略:首批公开 180 道种子题及其对应变体(共计 720 题),剩余题目构成受控隐藏测试集,有效防范训练数据泄露与评测污染。
- 跨架构模型兼容评测:已支持 OpenAI、Gemini、Anthropic、DeepSeek、Qwen、GLM、Kimi、LongCat 等 26+ 款主流闭源与开源模型的标准化推理性能比对。
General365的技术原理
- 八大推理维度驱动题目构建:将“通用推理”这一抽象能力显式分解为 8 类可操作、可标注、可复现的逻辑挑战范式,每道题目至少归属一类,近 70% 题目具备双重及以上维度标签,更贴近现实问题的复合性本质。
- 反模板化设计保障逻辑独立性:通过 t-SNE 可视化验证题目语义分布均匀性,并利用 Gemini 3 Pro 的推理路径相似度分析剔除逻辑趋同题目,显著抑制模型通过模式匹配或提示工程“套题”得分。
- 全流程质量管控体系:题目经历难度初筛、语义多样性增强、模型扩写辅助、专家多轮人工审核与一致性校准,最终形成 1460 道高质量、高信度评测样本。
- 分层评分框架适配不同题型:结构化答案(如数字、选项)由确定性规则引擎验证;非结构化输出(如推理步骤、策略说明)交由强模型+人工复核双保险机制判定。
General365的核心优势
- 直击通用智能短板:区别于 AIME、IMO 等聚焦数学专精能力的评测,General365 聚焦普通人无需专业训练即可应对的常识性逻辑任务,揭示当前大模型“学科强、常识弱”的结构性失衡。
- 保持高区分效能:SOTA 模型得分集中于 60%–63% 区间,未出现性能平台期,能有效拉开不同模型在深层推理链路上的真实差距。
- 经实证验证的强多样性:在语义空间与逻辑图谱两个维度上,其题目分布均匀性与结构独立性均显著优于 BBH、BBEH 等现有基准,降低“刷榜”可行性。
- 全栈开源与开箱即用:GitHub 提供完整评测 pipeline、数据加载器、评估脚本及文档,支持研究者与工程师零门槛接入、快速复现与二次开发。
General365的项目地址
- 官方主页:https://www.php.cn/link/6365eae9b4deb122bd2b3bd6558a02e7
- GitHub 仓库:https://www.php.cn/link/9965a8435897240bd3ada33e96a552f1
- Hugging Face 数据集:https://www.php.cn/link/983540b32f93c7aed4fd7fa3fd142a69
- arXiv 技术论文:https://www.php.cn/link/4832215be72e7fa0ff6539453731b5b3
General365的同类竞品对比
| 维度 | General365 | BBH (Big-Bench Hard) | BBEH (Big-Bench Extra Hard) |
|---|---|---|---|
| **评测重点** | 通用推理(K-12 知识) | 综合任务推理 | 高难度综合任务 |
| **题目数量** | 365 种子 + 1095 变体 | 23 项任务 | 多项任务扩展 |
| **多样性** | 极高(语义分布均匀,逻辑独立性强) | 较低(存在明显聚集现象) | 较低(模板化严重) |
| **难度区分度** | 高(SOTA 仅 62.8%) | 低(性能已饱和) | 中等 |
| **评分方式** | 混合评分(规则+模型,准确率 99.6%) | 规则评分为主 | 规则评分为主 |
| **数据公开策略** | 半公开(180 题公开 + 隐藏测试集) | 全公开 | 全公开 |
General365的应用场景
- 大模型研发闭环优化:助力算法团队定位推理薄弱环节(如语义干扰鲁棒性不足、多步策略规划缺失),定向提升复杂约束建模、隐式信息挖掘等关键子能力。
- 企业级模型选型决策依据:为金融、政务、客服等重视逻辑严谨性与常识一致性的行业用户提供客观、可比、可审计的推理性能参考。
- 通用人工智能学术基础设施:为 LLM 推理机理研究、提示工程有效性验证、思维链优化方法评估等方向提供统一、可信、可持续演进的评测平台。
- 推理效率-效果联合分析:支持同步采集准确率与 token 消耗量,量化评估模型在单位计算代价下的推理产出质量,推动高效推理技术发展。