





amd近日正式推出专为大语言模型推理部署打造的vllm-atom插件。该插件在不改动现有业务流程的基础上,显著提升deepseek-r1、kimi-k2等主流国产大模型在amd硬件平台上的推理效率与响应速度。
作为面向高并发、低延迟场景的开源推理引擎,vLLM长期以卓越的显存利用效率见长。此次AMD发布的插件深度适配其Instinct系列GPU架构,提供针对性更强的底层优化策略,使开发者能够以极小的学习与迁移成本,快速完成技术栈切换。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
达成性能无缝跃迁
vLLM-ATOM插件的关键特性在于“零改造”接入——用户无需调整任何已有API调用方式或端到端服务逻辑。插件在运行时自动接管请求分发、批处理调度及GPU内核执行路径,实现现有服务向AMD硬件后端的平滑过渡与性能跃升。

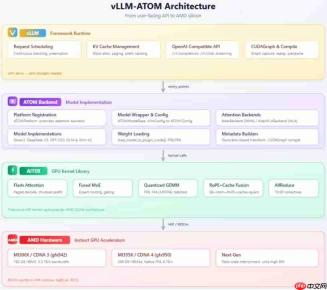
从系统架构来看,插件采用清晰的三层设计:顶层全面兼容OpenAI标准接口协议;中间层负责模型加载、路由分发与动态适配;底层则封装高度优化的GPU加速内核。该设计原生支持混合专家(MoE)结构与多种量化方案,为超大规模模型在线服务提供坚实支撑。
全面融入国产算力生态
插件重点适配AMD Instinct MI350与MI400系列高性能计算GPU,不仅对Qwen3、GLM等主流中文大模型提供开箱即用的支持,还广泛覆盖稠密模型、MoE架构模型以及视觉语言模型(VLM)等多种AI负载类型。
随着vLLM-ATOM的落地,AMD进一步压缩了企业级AI应用部署的技术门槛与实施周期。依托对DeepSeek-R1等前沿模型的深度协同优化,该工具将助力更多开发者高效释放AMD GPU算力潜能,构建更敏捷、更可靠的大模型在线服务能力。


