





近日,稀宇科技(minimax)发布了一份技术报告,深入解析了其 m2 系列模型在生成“马嘉祺”等特定人名时出现偏差的根本动因。这一表面偶然的输出失误,实则折射出当前大语言模型训练流程中一个长期被忽视却广泛存在的底层隐患。
词元偏移:向量空间中的“生存挤压”
症结所在,指向模型理解文本的最小单元——分词器(Tokenizer)。以“马嘉祺”为例,该姓名在模型内部被拆解为“马”与“嘉祺”两个独立词元。尽管这些片段已在预训练阶段通过海量语料获得初步表征,但真正的问题爆发于后续的“后训练”(即指令微调)阶段。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
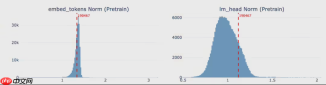
由于后训练所用的高质量对话数据中,“嘉祺”一词极少出现,该词元几乎未经历有效梯度更新,处于事实上的“训练休眠”状态。与此同时,代码符号、API 调用标记、结构化指令等高频词元持续接受高强度优化,其嵌入向量不断被拉伸与校准,无形中对低频词元的参数空间形成持续“挤压”。结果是,像“嘉祺”这类边缘词元逐渐偏离其原始语义锚点,概率分布发生漂移——当模型需准确唤出该艺人姓名时,只能依赖语音相似性,退而输出“佳琪”或“琪琪”。
跨语种蔓延:日语词元塌陷引发俄语“入侵”
MiniMax 的全面诊断进一步证实,此类“词元退化”并非孤立现象。团队对全词表约 20 万个词元展开系统性评估,发现其中约 4.9% 存在显著性能衰减。尤为突出的是日文词元,退化比例高达 29.7%,这直接解释了为何该模型在处理日语交互时,会偶发性地插入俄语字母或韩文字符。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
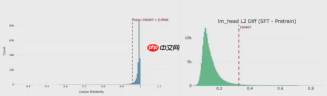
受影响范畴远不止人名与外语:LaTeX 数学公式标识符、维基百科原始标记语法、甚至部分早期 SEO 垃圾词也同步出现识别与生成失准。这一现象印证了一个关键结论——数据稀疏性所引发的失衡具有全局传染性:一旦后训练语料未能在语种维度、领域维度及词汇频率维度上实现均衡采样,模型的整体生成逻辑便会在统计层面悄然偏航。
结构性补救:“全词表低保机制”的建立
面对这一根植于训练范式的系统性挑战,研发团队并未采用粗放式重训,而是设计了一套精准干预策略:基于词表完整性,批量构建覆盖全部 20 万词元的合成训练样本,并部署“强制复述”任务,使每个词元在微调阶段至少获得一次稳定、可控的激活机会,从而为其设定最低限度的生成置信下限。
修复效果立竿见影:全词表输出一致性显著增强,日语响应中夹杂异语字符的比例由原先的 47% 断崖式回落至 1%。当前,团队正持续推进更底层的优化路径,包括在指令微调中动态注入预训练语料片段,以及对词表中已无实际使用价值的冗余符号执行裁剪清理。
此次事件正推动业界重新审视一个基础性命题:大模型的分词器常依托广域网络语料构建,具备天然泛化广度;而真实应用场景却高度垂直、语境严苛。如何在保障语义丰富性的同时,从词元级统计分布出发,筑牢数据覆盖的底层公平性,将成为衡量下一代大模型鲁棒性与可信度的核心标尺。


