





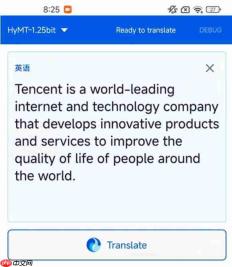
4月29日,腾讯混元团队正式对外开源其极限轻量化翻译模型——hy-mt1.5-1.8b-1.25bit。该模型最突出的特点在于:在完整支持33种语言互译的前提下,模型体积被极致压缩至约440mb,使得存储资源受限的移动终端也能在完全离线环境下,稳定运行高保真、低延迟的实时翻译服务。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
极致轻量:为手机存储“腾出空间”的技术突破
这一成果基于腾讯此前发布的专业级翻译大模型Hy-mt1.5。原始1.8B参数版本在FP16精度下需占用约3.3GB内存空间,对移动端部署构成显著挑战。为攻克该瓶颈,研发团队引入前沿的极低比特量化技术,将模型参数表达精度从标准的16位(16-bit)大幅压缩至最低1.25位。
形象地说,这相当于在保留图像核心语义与细节纹理的同时,将一张超高清4K图片高效转化为高度精简的缩略图。为适配不同硬件能力的终端设备,本次开源同步提供了2-bit与1.25-bit两套量化配置,在显著降低资源消耗的同时,确保模型仍具备出色的跨语言理解与生成能力。
实测表现:离线场景下翻译质量反超主流在线方案
尽管模型体量大幅缩减,其实际翻译性能却未打折扣。据官方公开测试结果显示,这款1.8B参数规模的轻量级模型,在多个权威翻译基准评测中,综合表现已达到甚至部分超越谷歌翻译等头部商业系统;在特定语种对及专业术语处理上,其效果可媲美参数量达235B的超大规模模型。
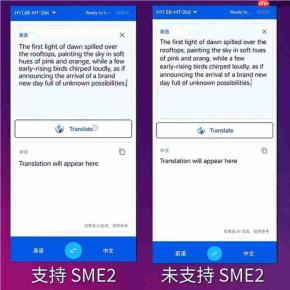

当前,该模型原生兼容中文、英语、日语、法语、俄语、阿拉伯语等33种语言,并特别覆盖藏语、蒙古语等少数民族语言。同时支持粤语、闽南语等5类方言,以及民汉双向互译,总计实现1056种翻译路径,极大拓展了离线多语种交互的应用深度与广度。
场景落地:兼顾隐私保护与操作流畅性的本地化体验
此次开源不仅限于模型权重,更已完成深度工程优化与真实场景验证。在最新演示版本中,模型已集成“后台智能取词”功能——用户在离线查阅邮件、浏览本地网页或处理文档时,均可一键触发即时翻译,响应迅捷、无感调用。
尤为关键的是,全部翻译运算均在设备端完成,全程无需上传文本、不采集用户数据、不依赖任何云端服务,从根本上规避隐私泄露风险,满足政务、金融、医疗等高敏感行业的合规需求。目前,该能力已在腾讯会议、腾讯文档、QQ浏览器等核心产品中规模化上线并稳定运行。
为便于开发者快速集成与二次开发,相关模型已同步发布于Hugging Face与魔搭(ModelScope)平台。这意味着高性能机器翻译正加速从云端集中式服务,演进为人人可装、处处可用、时时在线的终端级基础设施。


