





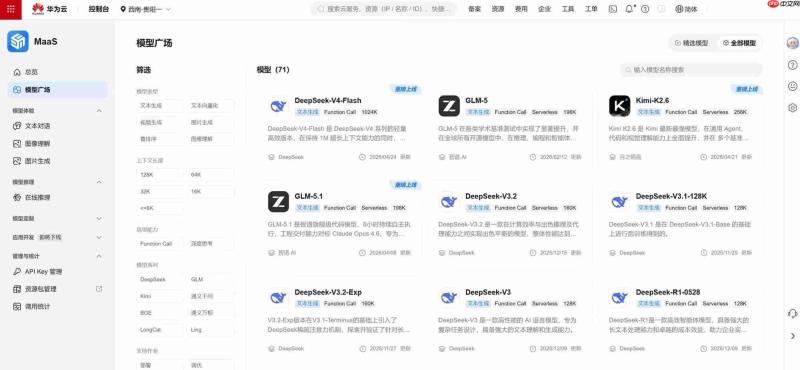
4月24日,deepseek-v4大模型正式发布并全面开源,华为云率先完成适配。该模型支持百万级token超长上下文,在智能体(agent)能力、全球知识覆盖以及复杂推理性能等方面,均达到国内乃至开源社区的领先水平。值得关注的是,其轻量高效版本——deepseek-v4-flash,参数量精简至284b,在显著降低推理开销的同时,进一步压缩模型参数规模与激活内存占用,从而提供更敏捷、更具成本效益的api服务,真正推动百万级上下文能力走向普惠化应用。目前,华为云maas(model-as-a-service)模型即服务平台已面向开发者开放免部署、一键调用的deepseek-v4-flash tokens服务。
为加速新模型落地,华为云在系统层、算子层与集群层开展深度协同优化,围绕调度效率、计算效率与数据流转效率三大核心维度,构建起支撑DeepSeek-V4高性能运行的全栈技术底座。
针对DeepSeek-V4独特的注意力机制,华为云首发实现模型分层注意力压缩技术,大幅提升KVCache资源分配与管理效率;同时集成TopK、SWA、CFA等十余种昇腾AI芯片专属高性能融合算子,并结合框架层异步调度策略、MTP多步推测解码等关键优化手段,全面支持原生100万Token长上下文的高吞吐、低延迟推理。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
华为云以高性能AI基础设施为根基,持续打造开放、包容、强韧的“硅基黑土地”,广泛兼容自研及第三方主流大模型与多样化智能体,助力企业破解实际业务难题,切实提升智能化生产效能。
目前,金山办公、360等头部企业已率先通过华为云接入DeepSeek-V4模型。此外,功能更强、能力更优的DeepSeek-V4-Pro版本也即将上线。






