





Location匹配需避免灾难性回溯:禁用嵌套量词与模糊通配符组合,锚定^$,用字符类替代.,优先原子组、占有量词及明确重复限制。
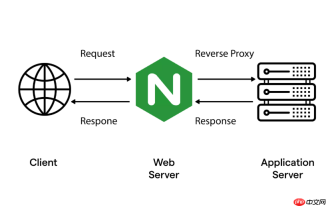
Location 匹配规则一旦写得不严谨,很容易触发灾难性回溯(Catastrophic Backtracking),尤其在 Web 服务中用于路由匹配、请求头解析或日志提取时,单次不匹配就可能让 CPU 持续 100% 数秒甚至更久。核心问题不在“匹配什么”,而在于“怎么试错”——NFA 引擎反复尝试、退回、再尝试,路径数爆炸式增长。
避免嵌套量词与模糊通配符组合
像 ^/.*?/.*?/.*?$ 或 ^/(.+)+$ 这类模式是高危写法。当输入为 /a/b/c/d/e/f/g/... 且末尾缺斜杠或含非法字符时,引擎需对每个 .+? 和外层 + 做指数级拆分尝试。
- ❌ 危险示例:
^/([^/]*)(/[^/]*)*$——(/[^/]*)*内部可空、外部可重复,造成大量等效路径 - ✅ 替代写法:
^/([^/]+(?:/[^/]+)*)?$—— 明确要求每段非空,用(?:...)非捕获组减少开销 - ? 更安全:直接限制层级,如
^/([^/]+)/([^/]+)/([^/]+)$(三段式)或配合{0,4}限定重复次数
用原子组和占有量词切断回溯入口
当某部分匹配成功后,无需再让它“吐出字符重试”,就该用原子组 (?>...) 或占有量词 ++、*+ 锁死匹配结果。
- ❌ 易回溯:
^/(\w+/)*\w+$—— 若末尾不满足\w+,引擎会反复缩减前面的(\w+/)* - ✅ 优化后:
^/(?>\w+/)*\w+$—— 一旦\w+/匹配完成,不再回退重试该组 - ? 小技巧:Java 中可用
a++b替代(a+)+b,避免嵌套贪婪引发的 O(2ⁿ) 复杂度
锚定起始与结束,拒绝无谓扫描
未加 ^ 和 $ 的 Location 匹配(如只写 /api/.*)会让引擎在长 URL 中反复尝试每个位置作为起点,尤其在失败场景下代价极高。
- ❌ 不推荐:
/api/users/\d+—— 可能从https://example.com/x/api/users/123中任意位置开始试 - ✅ 必须锚定:
^/api/users/\d+$—— 强制从开头匹配,失败即终止,不试探中间 - ⚠️ 注意:若需支持 query 参数(如
?page=1),不要用.*吞掉全部,改用[^?#]*精确截断路径部分
优先使用字符类替代点号,缩小搜索空间
. 是回溯大户,它匹配任意字符(包括换行需额外 flag),引擎必须穷举所有可能性。Location 路径有明确结构:字母、数字、短横线、下划线、斜杠——就该显式定义。
- ❌ 低效:
^/user/.+?/profile$——.+?仍可能跨段匹配,且回溯频繁 - ✅ 清晰高效:
^/user/[a-zA-Z0-9_-]+/profile$—— 排除非法字符,路径边界自然清晰 - ? 补充:对版本号、ID 等固定格式,直接写
v\d+\.\d+\.\d+或[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12},杜绝模糊试探



