





$upstream_addr能快速定位坏点,因其记录实际处理请求的上游服务器ip和端口(如10.0.1.22:8080),支持多地址分隔,结合$upstream_status、$upstream_response_time等字段可精准识别故障节点。
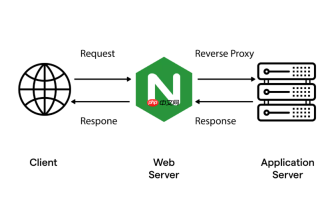
在 Nginx 作为反向代理接入后端服务集群时,若某台上游服务器(upstream server)出现响应超时、连接拒绝或返回异常状态码,仅靠 access log 中的 $status 或 $request_time 往往难以快速判断问题出在哪台具体机器上。启用 $upstream_addr 可以直接记录实际处理请求的上游服务器 IP 和端口,是定位“坏点”的关键字段。
为什么 $upstream_addr 能帮你快速定位坏点
$upstream_addr 记录的是 Nginx 实际转发请求到的后端地址(格式如 10.0.1.22:8080),支持多个地址(用逗号分隔),例如发生重试时会显示 10.0.1.22:8080, 10.0.1.23:8080。结合错误状态码(如 502/504)、高耗时或连接失败标记,你能在日志中一眼看出:哪次失败由哪台机器引发,是否因重试才成功,甚至识别出反复失败的“顽固节点”。
配置 log_format 包含 $upstream_addr
在 http 块中定义自定义日志格式,确保包含 $upstream_addr 和其他辅助诊断字段:

log_format upstream_log
  '$remote_addr - $remote_user [$time_local] '
  '"$request" $status $body_bytes_sent '
  '$upstream_addr $upstream_status $upstream_response_time '
  '"$http_referer" "$http_user_agent" '
  '$request_time $upstream_connect_time $upstream_header_time';
然后在 server 或 location 块中启用该格式:
access_log /var/log/nginx/upstream_access.log upstream_log;
配合使用的关键字段和排查技巧
-
$upstream_status:对应每次 upstream 请求的 HTTP 状态码(如 200、502、504),与
$upstream_addr一一匹配,可精准关联失败地址 - $upstream_response_time:该次请求在 upstream 的完整响应耗时,若某地址长期 >5s,大概率是性能瓶颈或假死
- $upstream_connect_time:建立 TCP 连接耗时,若持续 >100ms 或为 “-”,说明网络不通或目标端口未监听
- 注意日志中
$upstream_addr出现多个值的情况——逗号前的地址是首次尝试,后续是重试地址;若首地址后紧跟502,基本可断定它是坏点
进阶建议:让日志更易分析
- 开启
proxy_next_upstream error timeout http_502 http_504,确保异常时自动重试,从而让$upstream_addr更完整地反映故障链路 - 对关键业务 location 单独配置 access_log,避免被静态资源日志淹没
- 用
awk或日志分析工具按$upstream_addr分组统计错误率,例如:
awk '$9 ~ /502|504/ {print $7}' /var/log/nginx/upstream_access.log | sort | uniq -c | sort -nr





