





accept_mutex_delay用于控制worker进程抢锁失败后的重试延迟,以降低高并发下cpu锁竞争,而非负载均衡;仅在accept_mutex on时生效,典型值500ms。
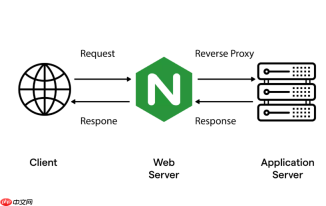
accept_mutex_delay 并不是用于负载均衡的配置项,它属于 Nginx events 块中与 accept_mutex 配合使用的参数,作用是控制工作进程在抢锁失败后等待重试的时间间隔,目的是减少多进程争抢新连接时的 CPU 竞争,提升高并发下的稳定性。
accept_mutex_delay 的真实作用
当多个 worker 进程同时监听同一个端口(如 80)时,新连接到达会触发所有 worker 的事件通知(惊群问题)。Nginx 默认开启 accept_mutex(1.11.3+ 版本默认 on),让 worker 进程通过内部互斥锁串行获取新连接。若某 worker 抢锁失败,就会进入休眠,等待 accept_mutex_delay 指定的时间(单位:毫秒)后再尝试——这个“延迟”不是为负载均衡设计,而是为降低锁竞争频率。
- 典型值:500ms(默认)、100ms、0(禁用延迟,立即重试,可能加剧竞争)
- 仅在
accept_mutex on时生效;若设为off,该指令被忽略 - 对单核或低并发场景影响小,但在高并发 + 多核 + 多 worker 场景下可缓解上下文切换和锁开销
它不参与负载均衡决策
Nginx 的负载均衡由 upstream 模块实现(如 round_robin、least_conn、ip_hash),发生在请求已进入某个 worker 进程并完成解析之后。而 accept_mutex_delay 发生在 TCP 连接刚建立、尚未读取 HTTP 请求头的最底层阶段,此时请求甚至还没被分发到具体 upstream server,更谈不上“均衡”。
- 真正影响后端分发的是
upstream中的weight、max_fails、fail_timeout等指令 - 若想控制请求分发节奏,应考虑
limit_req(限流)、queue(1.15.0+ upstream 队列)或上游服务自身的健康检查机制
配置建议与常见误区
除非观察到大量 worker 进程频繁抢锁(如 nginx -s reload 后短时 CPU 尖峰、perf trace 显示大量 futex 调用),否则无需调整 accept_mutex_delay。现代 Linux 内核(>=4.5)+ epoll + reuseport 已大幅缓解惊群问题。

- 启用
reuseport(需 kernel ≥ 3.9,Nginx ≥ 1.9.1):在listen指令后加reuseport,让内核直接分发连接到不同 worker,此时accept_mutex和accept_mutex_delay自动失效 - worker 数量建议设为
auto或等于 CPU 核心数,避免过多 worker 加剧锁竞争 - 不要误以为调大 delay 能“让流量更均匀”,实际可能导致部分 worker 空闲时间变长,反而降低吞吐
示例配置对比
以下配置仅作说明,非推荐模板:
events {
    worker_connections  1024;
    accept_mutex on;
    accept_mutex_delay 200ms;  # 抢锁失败后等 200ms 再试
}
更优实践(推荐):
events {
    worker_connections  4096;
    use epoll;
    multi_accept on;
}
<p>http {
upstream backend {
least_conn;
server 10.0.0.1:8080 weight=3;
server 10.0.0.2:8080 max_fails=2 fail_timeout=30s;
}</p><pre class="brush:php;toolbar:false;">server {
    listen 80 reuseport;  # 内核级分发,绕过 accept_mutex
    location / {
        proxy_pass http://backend;
    }
}
}


