





一、引言
在日常工作场景中,批量处理合同、报告类文档是高频刚需,传统人工逐份阅读、总结、分类的模式,不仅耗时耗力、易漏关键信息,还存在敏感数据泄露风险。而基于本地批量文档处理方案,恰好破解了这些痛点。不仅不需要联网部署,能在本地设备安全处理数百份文档,兼顾处理效率与数据隐私保护。
依托模型强大的文本理解能力与Schema引导输出机制,可快速生成标准化摘要与多标签分类,配合TextSplitter完美适配长文档处理需求,最终以CSV格式输出结构化结果。无论是梳理合同台账、归档报告,还是提取核心数据,该方案都能大幅降低人工成本,提升文档处理的精准度与标准化水平,成为大模型本地化落地的核心实用场景之一。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
二、基础概念理解
在开始实操前,我们先明确几个关键概念,这是后续所有操作的基础:
1. 批量文档摘要与分类:针对本地存储的数百份合同、报告等文档,无需手动逐个阅读,通过AI自动提取每份文档的核心信息(摘要),并按照预设规则标注对应的业务标签(分类),最终输出结构化结果(如CSV)供后续使用。
2. Qwen 1.5 7B:通义千问推出的开源大语言模型(7B代表模型参数量为70亿),具备优秀的文本理解、总结与分类能力,支持本地部署运行,无需联网,能保障合同等敏感文档的安全性,是本地批量处理文档的最优选型之一。
3. TextSplitter:文本分割工具,由于大模型存在上下文窗口限制,Qwen 1.5 7B默认上下文窗口通常为4096 tokens,约3000字左右,超过限制的长文档(如万字合同)无法直接输入模型,TextSplitter会将长文档分割为多个符合窗口限制的小文本块,再逐块处理、最终整合结果。
4. Schema 引导输出:通过明确的格式要求(如固定模板、字段)引导大模型输出标准化结果,避免模型输出格式混乱,如有的写摘要在前,有的写分类在前,方便后续批量处理和CSV导出。
5. 多标签分类:一份文档可能对应多个类别,如一份房屋租赁合同,可同时标注"合同"、"租赁类"、"办公相关"三个标签,区别于每个标签只能选一个的场景,更贴合实际文档处理需求。
三、应用流程原理
1. 整体流程
批量文档摘要与分类的核心逻辑是"批量读取→文本预处理→分块→AI处理→结果整合→CSV导出",每一步的作用如下:

流程说明:
1. 批量读取:遍历指定文件夹,自动识别并读取所有.docx/.pdf文档的文本内容。2. 文本预处理:清理文档中的无效字符(如分页符、空格、乱码)、去除冗余内容(如页眉页脚、签名栏),减少模型处理干扰。3. 文本分块:通过TextSplitter将长文本分割为符合模型上下文窗口限制的小文本块,同时保证语义完整性。4. AI处理:将每个文本块输入Qwen 1.5 7B,通过预设的Schema提示词引导模型生成该块的摘要与分类,再将所有块的结果整合为完整文档的摘要与分类。5. 结果整合:将每份文档的「文件名→原文路径→完整摘要→多标签」整理为结构化数据。6. CSV导出:将结构化数据写入CSV文件,方便后续在Excel中查看、编辑、分析。2. TextSplitter 分块原理
常用的TextSplitter(如RecursiveCharacterTextSplitter)采用“递归分割+语义保留”策略,具体步骤:
1. 预设分割符优先级:(段落分隔)> (换行)>(空格)> ``(无分隔符,强制分割)。2. 从最高优先级分割符开始,尝试将文本分割为多个片段,每个片段的token数不超过预设阈值,如3000tokens。3. 若某个片段无法用当前分割符分割到阈值内,则降级使用下一个优先级分割符。4. 最后,为每个片段添加少量重叠内容(如前一个片段的最后50个token),避免分割导致的语义断层,保证后续整合结果的完整性。
3. Schema 提示词引导原理
大模型的输出具有跟随性,即会根据用户提供的格式要求调整输出形式。Schema 提示词的核心是"明确任务+固定格式+示例引导",让模型输出标准化结果,具体逻辑:
1. 明确任务:告诉模型我们需要总结文档核心信息,并标注多标签。2. 固定格式:定义输出的字段,如"文档摘要"、"多标签分类",并规定字段的呈现形式,如用"###"分隔,标签用","分隔。3. 示例引导:提供1-2个简单示例,让模型更直观地理解格式要求,减少格式错误。4. 约束条件:告诉模型"标签仅从预设列表中选择"、"摘要控制在200字以内",避免输出不符合需求的内容。4. 大模型的价值体现
1. 发挥大模型的文本理解优势:大模型具备强大的上下文理解和语义归纳能力,相比传统的关键词匹配分类、规则式摘要,能更准确地提取合同/报告的核心信息,处理复杂句式和隐含语义。2. 落地大模型的本地实用场景:批量文档处理是企业/个人的高频需求,本地部署大模型处理,既保障了数据安全,敏感合同不泄露,又降低了使用成本,无需按调用次数付费,是大模型从演示到实用的重要落地场景。3. 验证大模型的工程化能力:通过TextSplitter解决上下文窗口限制、通过Schema解决输出标准化、通过批量处理解决效率问题,这些步骤是大模型工程化落地的核心环节,为后续更复杂的AI应用打下基础,如智能合同审查、报告分析系统等。4. 优化大模型的输出效果:Schema 提示词和文本分块是大模型应用的常用优化手段,通过这些手段可以让大模型的输出更贴合实际需求,减少后续人工处理成本,提升大模型的实用价值。四、示例运行解析
1. 文档准备
将需要处理的数百份合同/报告整理到同一个本地文件夹中,要求如下:
1. 格式统一,优先推荐.docx或.pdf,可按需扩展其他需要支持的格式。2. 文件名清晰,如“20250101-房屋租赁合同-甲方XX.docx”,方便后续对应结果。3. 文件夹路径无中文特殊字符,如避免"D:\我的文档\合同\未处理",可改为"D:\Documents\Contracts\ToProcess",防止代码读取报错。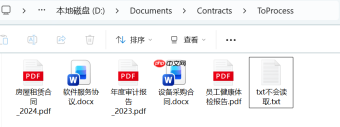
2. 批量读取文档(支持docx和pdf)
此部分完成对指定文件夹中 .docx 和 .pdf 文档的批量读取,提取原始文本并初步调用清洗函数,是整个流程的数据入口。
<code class="python"># 导入所需库import osimport reimport pandas as pdfrom docx import Documentimport PyPDF2# ======================================# 配置参数(只需修改这部分路径和参数)# ======================================MODEL_PATH = r"D:\AIWorld\models\Qwen1.5-7B-Chat-4bit"  # Qwen 1.5 7B模型路径DOCUMENT_FOLDER = r"D:\Documents\Contracts\ToProcess"  # 文档文件夹路径OUTPUT_CSV_PATH = r"D:\Documents\Contracts\Batch_Result.csv"  # 输出CSV文件路径MAX_SUMMARY_LENGTH = 200  # 摘要最大字数MAX_CHUNK_TOKENS = 3000  # 每个文本块的最大token数CHUNK_OVERLAP_TOKENS = 50  # 文本块之间的重叠token数# 预设多标签列表(可根据你的业务需求修改/扩展)PREDEFINED_TAGS = ["合同", "租赁类", "买卖类", "服务类", "报告", "财务报告", "审计报告", "项目报告", "办公相关", "个人相关"]# ======================================# 步骤1:工具函数 - 读取单个文档(支持.docx和.pdf)# ======================================def read_single_document(file_path):    """    读取单个文档的文本内容,支持.docx和.pdf格式    :param file_path: 单个文档的完整路径    :return: 清理后的文档文本内容    """    text_content = ""        # 区分文档格式,分别处理    if file_path.endswith(".docx"):        try:            doc = Document(file_path)            for paragraph in doc.paragraphs:                if paragraph.text.strip():  # 跳过空段落                    text_content += paragraph.text + "<p>"        except Exception as e:            print(f"读取.docx文档失败:{file_path},错误信息:{str(e)}")            return ""        elif file_path.endswith(".pdf"):        try:            with open(file_path, "rb") as pdf_file:                pdf_reader = PyPDF2.PdfReader(pdf_file)                for page in pdf_reader.pages:                    page_text = page.extract_text()                    if page_text.strip():  # 跳过空页面                        text_content += page_text + "</p>
<p>"        except Exception as e:            print(f"读取.pdf文档失败:{file_path},错误信息:{str(e)}")            return ""        else:        print(f"不支持的文档格式:{file_path}")        return ""        # 文本预处理:清理无效字符、冗余空格    text_content = clean_text(text_content)    return text_content</p></code>
重点说明:
支持主流办公文档格式(Word 和 PDF),通过 python-docx 和 PyPDF2 提取纯文本;跳过空段落/空页,避免无效内容干扰;提取后立即调用 clean_text() 进行初步清洗,为后续处理奠定基础。2. 文本预处理(清洗与标准化)
对提取的原始文本进行深度清洗,去除控制字符、页码、版权信息及冗余空白,输出干净、结构化的纯文本,为后续分块提供高质量输入。

<code class="python"># ======================================# 步骤2:工具函数 - 文本预处理(清理无效内容)# ======================================def clean_text(text): """ 清理文本中的无效字符、冗余空格、分页符等 :param text: 原始文本内容 :return: 清理后的文本内容 """ # 去除多余的空格、换行符 text = re.sub(r"+", "<p>", text) text = re.sub(r"\s+", " ", text) # 去除常见的无效字符(如分页符、特殊符号) text = re.sub(r"[\x00-\x08\x0b\x0c\x0e-\x1f\x7f]", "", text) # 去除页眉页脚常见的重复内容(可根据你的文档情况扩展) text = re.sub(r"第\d+页/\d+页", "", text) text = re.sub(r"版权所有\s*©.*", "", text) return text.strip()</p></code>
重点说明:
使用正则表达式清除分页符、页眉页脚、版权信息等非语义噪声;统一空白与换行格式,保留段落结构(分段);输出干净、连续的文本流,提升后续分块与模型理解的准确性。
3. 文本分块(适配模型上下文窗口)
利用 LangChain 的智能分块器,按 token 数精准切分长文档,保留语义边界,如按段落切分,并设置重叠区域防止关键信息断裂,确保每块可被模型有效处理。
<code class="python">from langchain.text_splitter import RecursiveCharacterTextSplitter# ======================================# 步骤3:工具函数 - 文本分块(使用Langchain的RecursiveCharacterTextSplitter)# ======================================def split_text_into_chunks(text, tokenizer): """ 将长文本分割为符合模型上下文窗口限制的小文本块 :param text: 清理后的完整文档文本 :param tokenizer: 模型对应的tokenizer :return: 文本块列表 """ # 初始化文本分割器 text_splitter = RecursiveCharacterTextSplitter( chunk_size=MAX_CHUNK_TOKENS, chunk_overlap=CHUNK_OVERLAP_TOKENS, length_function=lambda x: len(tokenizer.encode(x)), # 以token数作为长度计算标准 separators=["<p>", "", " ", ""] # 分割符优先级 ) # 执行分割 chunks = text_splitter.split_text(text) return chunks</p></code>
重点说明:
利用 LangChain 的递归分块器,按 token 数(非字符数)精准控制块大小;设置 chunk_overlap=50 避免语义割裂(如句子被切断);优先在语义边界(段落 > 行 > 空格)切分,保障每块内容完整性;适配 Qwen 模型上下文限制(如 32K),确保长文档可处理。4. 调用本地大模型摘要分类
此部分为核心大模型处理层,通过结构化 Prompt 引导 Qwen 模型生成标准化摘要与多标签,并解析输出;最后将多个文本块结果融合为完整文档级结果。
<code class="python">from transformers import AutoTokenizer, AutoModelForCausalLM, pipelineimport torch# ======================================# 步骤4:工具函数 - 构建Schema提示词# ======================================def build_prompt(chunk_text): """ 构建符合Schema要求的提示词,引导模型输出标准化结果 :param chunk_text: 单个文本块的内容 :return: 完整的提示词 """ prompt = f"""你是一名专业的文档处理助手,负责总结文档核心信息并标注多标签分类。请严格按照以下要求完成任务:1. 文档摘要:总结该文本块的核心信息,控制在{MAX_SUMMARY_LENGTH}字以内,语言简洁、准确,不遗漏关键信息。2. 多标签分类:从预设标签列表中选择1个或多个符合文本内容的标签,标签之间用英文逗号","分隔,不得使用预设列表外的标签。3. 输出格式:严格按照以下固定格式输出,不得添加任何额外内容、注释或标点符号:### 文档摘要[你的摘要内容]### 多标签分类[你的标签内容]预设标签列表:{",".join(PREDEFINED_TAGS)}文本块内容:{chunk_text}""" return prompt.strip()# ======================================# 步骤5:工具函数 - 调用Qwen 1.5 7B模型处理单个文本块# ======================================def process_single_chunk(chunk_text, model, tokenizer): """ 调用Qwen 1.5 7B模型,处理单个文本块,生成摘要与分类 :param chunk_text: 单个文本块的内容 :param model: 加载后的Qwen 1.5 7B模型 :param tokenizer: 加载后的模型tokenizer :return: 该文本块的摘要(str)、标签(str) """ # 构建提示词 prompt = build_prompt(chunk_text) # 构建模型输入(符合Qwen模型的输入格式要求) messages = [ {"role": "user", "content": prompt} ] input_ids = tokenizer.apply_chat_template(messages, return_tensors="pt").to(model.device) # 模型生成配置(控制输出长度、避免重复) generation_config = { "max_new_tokens": 500, # 足够容纳摘要和标签 "temperature": 0.3, # 温度越低,输出越稳定、越符合格式要求 "top_p": 0.9, "do_sample": False, # 关闭采样,保证输出一致性 "eos_token_id": tokenizer.eos_token_id, "pad_token_id": tokenizer.pad_token_id } # 执行生成 with torch.no_grad(): # 关闭梯度计算,减少内存占用 outputs = model.generate(input_ids, **generation_config) # 解析输出结果 response = tokenizer.decode(outputs[0][input_ids.shape[1]:], skip_special_tokens=True).strip() # 提取摘要和标签(按照Schema格式解析) summary = "" tags = "" try: # 匹配"### 文档摘要"后的内容 summary_match = re.search(r"### 文档摘要(.*?)### 多标签分类", response, re.DOTALL) # 匹配"### 多标签分类"后的内容 tags_match = re.search(r"### 多标签分类(.*)", response, re.DOTALL) if summary_match: summary = summary_match.group(1).strip() if tags_match: tags = tags_match.group(1).strip() except Exception as e: print(f"解析模型输出失败,错误信息:{str(e)},模型原始输出:{response}") return summary, tags# ======================================# 步骤6:工具函数 - 整合多个文本块的结果# ======================================def integrate_chunk_results(chunk_summaries, chunk_tags): """ 整合所有文本块的摘要和标签,生成完整文档的结果 :param chunk_summaries: 所有文本块的摘要列表 :param chunk_tags: 所有文本块的标签列表 :return: 完整摘要(str)、完整标签(str) """ # 整合摘要:去重后拼接,保持简洁 integrated_summary = "".join([s for s in chunk_summaries if s]) # 若整合后摘要过长,再次精简(取前MAX_SUMMARY_LENGTH*2字,避免过长) if len(integrated_summary) > MAX_SUMMARY_LENGTH * 2: integrated_summary = integrated_summary[:MAX_SUMMARY_LENGTH * 2] + "..." # 整合标签:去重,保持格式统一 all_tags = [] for tag_str in chunk_tags: if tag_str: tags = [t.strip() for t in tag_str.split(",")] all_tags.extend(tags) # 去重并排序,保持结果一致性 unique_tags = sorted(list(set(all_tags))) integrated_tags = ",".join(unique_tags) return integrated_summary, integrated_tags</code>
重点说明:
通过 Schema Prompt 强约束输出格式,确保结果可解析;使用 Qwen 官方 apply_chat_template 构造合规输入;低温度 + 关闭采样 → 提升输出稳定性与格式一致性;正则精准提取字段,避免模型自由发挥导致解析失败。5. CSV 导出(结构化结果交付)
主流程协调全流程:加载模型 → 遍历文档 → 调用前述各模块 → 汇总结果 → 导出为带中文编码的 CSV 文件,实现全端的自动化处理,输出可直接用于业务系统或人工审核。
<code class="python"># ======================================# 步骤7:主函数 - 批量处理所有文档# ======================================def batch_process_documents(): """ 批量处理指定文件夹中的所有文档,生成摘要与分类,最终导出CSV """ # 步骤7.1:加载Qwen 1.5 7B模型和tokenizer print("开始加载Qwen 1.5 7B模型,请稍候(首次加载可能需要1-2分钟)...") try: # 加载tokenizer tokenizer = AutoTokenizer.from_pretrained( MODEL_PATH, trust_remote_code=True ) # 加载模型 model = AutoModelForCausalLM.from_pretrained( MODEL_PATH, trust_remote_code=True, torch_dtype=torch.float16, # 使用float16精度,减少内存占用 device_map="auto" # 自动分配设备(优先使用GPU,无GPU则使用CPU) ) # 模型设置为评估模式 model.eval() print("模型加载成功!") except Exception as e: print(f"模型加载失败,错误信息:{str(e)}") return # 步骤7.2:初始化结果列表 result_list = [] # 步骤7.3:遍历文档文件夹,批量处理每个文档 print(f"开始遍历文档文件夹:{DOCUMENT_FOLDER}") for file_name in os.listdir(DOCUMENT_FOLDER): file_path = os.path.join(DOCUMENT_FOLDER, file_name) # 仅处理.docx和.pdf文件 if not (file_path.endswith(".docx") or file_path.endswith(".pdf")): continue print(f"开始处理文档:{file_name}") # 步骤7.3.1:读取文档文本 doc_text = read_single_document(file_path) if not doc_text: print(f"文档{file_name}无有效文本,跳过处理") continue # 步骤7.3.2:文本分块 text_chunks = split_text_into_chunks(doc_text, tokenizer) print(f"文档{file_name}分割为{len(text_chunks)}个文本块") # 步骤7.3.3:处理每个文本块 chunk_summaries = [] chunk_tags = [] for idx, chunk in enumerate(text_chunks): print(f"正在处理第{idx+1}/{len(text_chunks)}个文本块") summary, tags = process_single_chunk(chunk, model, tokenizer) chunk_summaries.append(summary) chunk_tags.append(tags) # 步骤7.3.4:整合文本块结果 integrated_summary, integrated_tags = integrate_chunk_results(chunk_summaries, chunk_tags) # 步骤7.3.5:添加到结果列表 result_list.append({ "文档文件名": file_name, "文档完整路径": file_path, "文档摘要": integrated_summary, "多标签分类": integrated_tags }) print(f"文档{file_name}处理完成,摘要:{integrated_summary[:50]}...,标签:{integrated_tags}") # 步骤7.4:将结果导出为CSV文件 if result_list: try: df = pd.DataFrame(result_list) df.to_csv(OUTPUT_CSV_PATH, index=False, encoding="utf_8_sig") # utf_8_sig支持Excel中文显示 print(f"所有文档处理完成!结果已导出至CSV文件:{OUTPUT_CSV_PATH}") except Exception as e: print(f"CSV文件导出失败,错误信息:{str(e)}") else: print("无有效文档处理结果,未生成CSV文件")# ======================================# 运行主函数# ======================================if __name__ == "__main__": batch_process_documents()</code>
重点说明:
汇总所有文本块的摘要先拼接,再进行标签的去重+排序,生成文档级结果;使用 pandas 构建结构化表格,字段包括:文件名、路径、摘要、标签;encoding="utf_8_sig" 确保 Excel 正确显示中文,便于业务人员直接使用;最终输出为标准 CSV,可无缝对接数据库、BI 工具或人工审核流程。6. 运行流程和输出

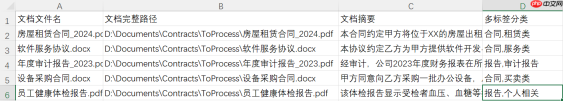
示例输出:
Batch_Result_Simulated.csv文件内容预览:
7. 优化与扩展
7.1 TextSplitter 优化细节
1. 以Token数为长度标准:代码中使用length_function=lambda x: len(tokenizer.encode(x)),直接以模型的token数作为文本块长度的计算标准,比以字符数更准确,因为不同字符的token数不同,如中文汉字通常1个字符=1个token,英文单词通常1个单词=多个token。2. 重叠token设置:CHUNK_OVERLAP_TOKENS=50,让相邻文本块之间有50个token的重叠内容,避免分割导致的语义断层,如一份合同的某个条款被分割在两个文本块中,重叠部分可以保证模型理解完整条款。3. 分割符优先级:优先使用(段落分隔)分割,保证每个文本块尽可能是一个完整的段落,最大化保留语义完整性。
7.2 Schema 提示词优化细节
1. 格式强制约束:明确要求模型严格按照固定格式输出,不得添加任何额外内容,并使用###分隔字段,方便后续用正则表达式解析。2. 预设标签列表:将标签限制在预设列表中,避免模型输出不规范的标签,如"租赁合同"和"租赁协议"同时出现,保证分类结果的统一性。3. 示例隐含引导:虽然代码中未直接给出完整示例,但通过明确的字段定义和格式要求,模型已能理解输出规范,若需要进一步提升格式准确率,可在提示词中添加1个简单示例,如在输出格式后添加"示例:### 文档摘要本次合同为甲方与乙方的房屋租赁协议,租赁期限为1年。### 多标签分类合同,租赁类,办公相关"。7.3 结果整合优化细节
1. 摘要去重与精简:整合多个文本块的摘要时,先去重再拼接,若拼接后过长则进一步精简,避免摘要冗余。2. 标签去重与排序:整合多个文本块的标签时,先去重避免同一个标签出现多次,再排序,保证标签格式的统一性,便于后续筛选分析。五、总结
总的来说,示例比较简单直接,相比前几期的烧脑轻松了许多,今天这个本地批量文档处理方案不难上手,核心就是把“读文档、切文本、模型处理、导结果”这几步串起来。我们不用怕复杂,先把基础环境搭好,用自己比较熟悉的模型也可以,普通办公本就能跑通。重点吃透TextSplitter分块和Schema提示词这两个点,前者解决长文档处理难题,后者保证输出格式统一,这俩弄明白了,整体流程就顺了。
建议大家先拿10份左右的文档做测试,调整分块重叠度和提示词细节,跑通后再批量处理。遇到格式解析问题,优先检查提示词约束和正则表达式。平时可以多扩展预设标签,适配不同业务场景。慢慢摸索模型参数微调,处理效率和准确率会越来越高,这套方法落地后能省不少人工,值得多花点时间打磨。






