





4月2日,工业和信息化部正式发布《关于开展普惠算力赋能中小企业发展专项行动的通知》,明确设定目标:到2028年底全面建成覆盖广泛、便捷可及的普惠算力服务体系,切实压降中小企业获取与使用算力的综合门槛。如何推动原本集中于头部企业的高端算力资源,真正下沉至制造业、农业、服务业等“千行百业”,已成为当前产业数字化转型的关键命题。
中科曙光全新推出的无线缆箱式超节点scaleX40,精准锚定算力规模化落地中的现实堵点,凭借部署零改造、运行高可靠、交付即启用的系统级创新,为普惠算力从政策蓝图走向产线实操提供了清晰可行的技术路径。
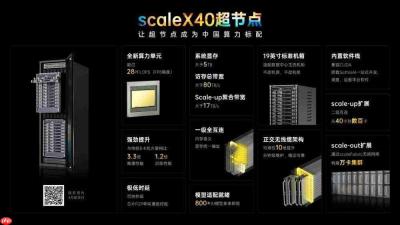
标准化箱体结构,免改造兼容现有基础设施
多数中小企业受限于场地、预算与运维能力,难以自建智算中心。在既有数据中心内高效嵌入高密算力,成为普遍性难题。scaleX40采用通用19英寸标准箱体设计,单台超节点仅需16U机架空间,体积相当于半台常规机柜。无需调整供电系统、地板承重结构或加装液冷管道,即可无缝接入99%以上的存量机房环境。单个标准机柜可并列部署两台scaleX40,共容纳80张GPU,算力密度显著优于传统8卡服务器;同时规避了整柜式超节点超2吨承重压力及高昂液冷工程改造成本。在采购侧,其投入成本相较传统柜式超节点实现数量级压缩。
正交无缆互联架构,终结布线依赖与运维低效

传统超节点高度依赖密集铜缆或光纤完成节点间高速互连,一个机柜内线缆缠绕复杂,安装调试常耗时数小时,故障定位难、更换周期长。scaleX40首创正交无线缆一级直连架构——计算单元与交换单元通过精密对插实现物理与电气直连,彻底摆脱线缆束缚。该设计将系统可用性由99.9%跃升至99.99%,部署与维护时间从“小时级”压缩至“分钟级”,整体运维效率提升达10倍。此外,相较主流光纤互连方案,整机功耗降低40%–70%,长期运营支出大幅优化。
性能全面释放,即开即用零适配延迟
scaleX40单节点集成40张GPU,整机算力突破28PFLOPS(FP8精度),HBM显存总量逾5TB,scale-up聚合带宽高达17TB/s以上,可原生支撑万亿参数MoE大模型训练,并为KVCache预留充足显存冗余。对比传统8卡服务器,其训练吞吐提升20%,推理吞吐提升40%,而整机采购成本保持基本持平。配套搭载SothisAI一站式AI开发平台,全面兼容CUDA生态,预置800+主流AI模型,真正做到“拆箱即训、上电即推”。
紧扣国家算力普惠战略导向,scaleX40致力于助力中小企业跨越算力鸿沟,实现高端超节点算力“买得起、装得快、跑得稳、用得精”,重塑企业级AI基础设施的基本组成单元,加速人工智能技术在各行业场景中的规模化、常态化、实效化落地。


