





谷歌这次,真把压箱底的绝活都亮出来了。
凌晨时分,谷歌DeepMind正式官宣Gemma 4,一次性推出四款全新开源大模型。
从能轻松装进手机的2B小钢炮,到单张显卡就能全量加载的31B旗舰,覆盖全场景尺寸——全部基于Gemini 3同源技术架构深度打磨而来。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
沉寂一年后,Gemma 4强势回归,性能实现跨越式升级。
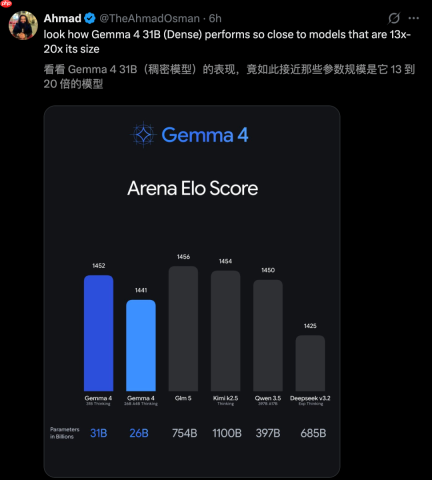
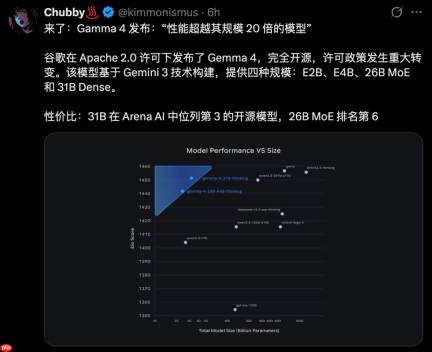
最震撼的数据来了:31B Dense版在Arena AI文本评测榜中杀入开源模型前三甲,Elo评分高达1452。
排在它前面的两个对手,参数量分别超600亿和破千亿元。而Gemma 4仅凭310亿参数,硬生生闯入这场“巨无霸”竞技场。
更夸张的是26B MoE版本:总参数260亿,推理时却只激活38亿,Elo仍飙至1441,稳坐开源第六。
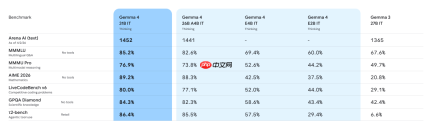
翻看综合成绩单,Gemma 4几乎找不到短板,堪称对上一代的全面降维打击——
数学能力(AIME 2026):89.2% vs 21.2%,暴涨68个百分点;
编程水平(LiveCodeBench):80% vs 29.1%,实力断层式领先;
智能体表现(t2-bench):Gemma 4拿下86.4%,前代仅为6.6%,差距之大令人瞠目。
此外,在多语言理解、知识问答等主流基准测试中,Gemma 4整体性能跃升达40%。
更让人脊背一凉的是:一个31B的Gemma 4,竟能越级击败参数量是其整整20倍的竞品模型。
Mac mini即可本地运行Gemma 4,已有开发者实测在安卓手机上成功部署。
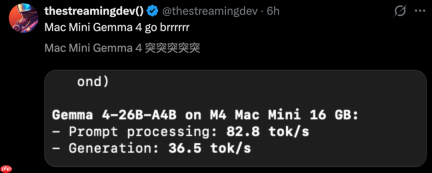
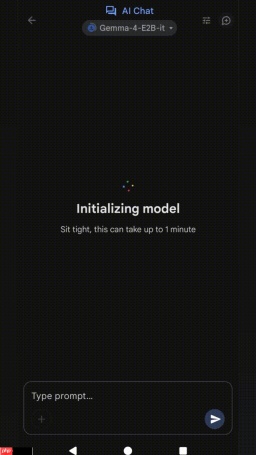
Hugging Face CEO Clément Delangue只用一句话评价:“这是个划时代的里程碑。”
四款模型,端到云无缝覆盖
先来看Gemma 4“全家福”的具体构成——
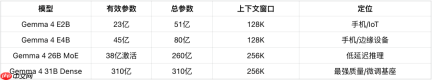
每个尺寸均提供base基础版与instruction-tuned指令微调版两种选择。
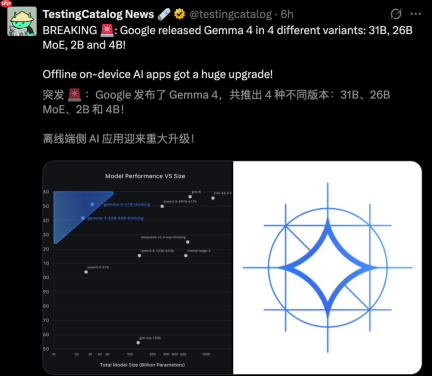
E2B和E4B专为边缘侧优化,联合谷歌Pixel团队、高通、联发科深度适配,可在智能手机、树莓派、Jetson Orin Nano等设备上离线运行,响应延迟趋近于零。
31B与26B则面向开发者工作站及服务器环境:31B主打极致生成质量,26B凭借MoE稀疏激活架构实现超高推理吞吐。
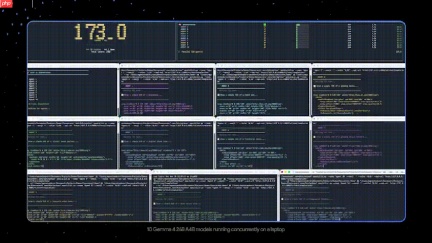
对工程师而言,31B的bfloat16权重可完整塞入一张80GB H100;量化轻量版甚至能在消费级显卡上流畅运行。
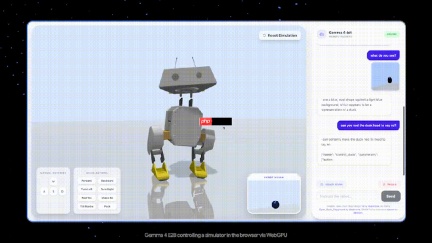
26B MoE因仅需激活3.8B参数,Token输出速度极快,特别适合低延迟Agent任务。
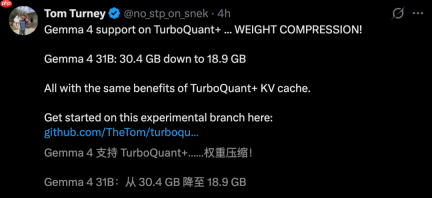
值得一提的是,Gemma 4还集成了曾引发争议的TurboQuant压缩算法。
跑分狂暴,跨档吊打
看完定位再看实测。
31B在数学推理方面尤为惊艳。AIME 2026得分89.2%,相较Gemma 3 27B的20.8%,提升超四倍。
GPQA Diamond(高阶科学知识)达84.3%,大幅甩开前代。
编程能力同样炸裂:LiveCodeBench v6斩获80%,Codeforces Elo高达2150,相当于国际竞赛紫名选手水准;26B MoE亦不逊色,LiveCodeBench 77.1%,Codeforces 1718。
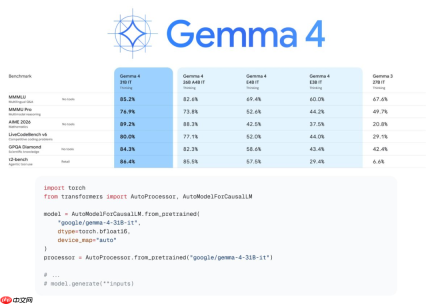
多模态能力全面跃升。MMMU Pro(多模态理解)中,31B拿下76.9%,26B达73.8%,双双碾压前代的49.7%。
长上下文处理能力也有质变。MRCR v2 8-needle 128K测试中,31B得分为66.4%,26B为44.1%,而Gemma 3 27B仅13.5%。
就连最小的E4B也不掉队:AIME得分42.5%,LiveCodeBench达52%,对于一个仅含45亿有效参数的模型来说,这成绩放在一年前已是旗舰水准。
三大核心架构创新
让小模型打出大模型的战斗力
Gemma 4并未堆砌炫技式新结构,而是将多个成熟可靠的技术模块组合至最优状态。
谷歌明确表示,已剔除Altup等“效果存疑”的组件,只保留真正经过验证的有效设计。
逐层嵌入(Per-Layer Embeddings,PLE)
传统Transformer中,每个token在输入层获得统一嵌入向量,后续所有层均依赖该初始表示运算。问题在于,嵌入层需一次性承载全部语义信息,负担过重。

PLE则为每一层单独配备低维信号通道。
每个token在每一层都能接收到由自身身份+上下文动态生成的定制化向量。
类比来说:传统方式像出门前把全天用品全塞进一个背包;PLE则是每到一处,都有专人递来当下最需要的工具。
由于PLE维度远小于主隐藏层,额外开销极小,却赋予每层专属调节能力。这一设计在小模型上效果尤为突出,正是E2B/E4B以极小体积达成高性能的关键所在。
共享KV缓存
最后N层不再重复计算Key和Value投影,而是直接复用前序层的KV张量。同类注意力机制(滑动窗口或全局注意力)共享同一组KV状态。
显著降低推理时显存占用与计算量,尤其利好长文本生成与端侧部署。谷歌称其对模型质量影响“几乎不可测”。
交替注意力机制
模型交替启用局部滑动窗口注意力与全局全上下文注意力。
小模型采用512 token滑动窗口,大模型扩展至1024。全局层配合等比例RoPE延长上下文感知范围,滑动层使用标准RoPE维持局部建模效率。
三项设计共同指向唯一目标:让每一个参数都被高效利用。
看图、听声、读视频
一个Gemma,全模态通吃
Gemma 4全系支持图像与视频输入,E2B和E4B额外兼容音频处理。
视觉编码器相比Gemma 3完成两项关键升级:一是支持可变宽高比输入(告别强制裁切),二是提供五档可配置图像token预算(70/140/280/560/1120),按需切换。
低预算适用于分类与描述任务,高预算专攻OCR与文档解析。开发者可在推理速度与识别精度间自由权衡。
GUI元素精准定位。
输入一张网页截图,提问“view recipe按钮在哪”,四个尺寸均能以JSON格式返回精确边界框坐标,无需特殊提示词。其中31B定位最准,E2B略有偏差但基本可用。
视频理解能力扎实。
以一段现场演唱会视频测试:E4B准确还原舞台画面,并从音轨中提取出歌词核心主题。
26B与31B虽不支持音频输入,但在纯视觉理解上同样出色,甚至识别出屏幕上的赞助商品牌名称。
语音转写自然流畅。
E4B对英文演讲音频转写近乎完美,标点与断句逻辑自然;E2B偶有幻觉,但整体可用性良好。
多模态函数调用原生支持。
上传一张曼谷寺庙照片,提问“这是哪个城市?帮我查下当地天气”。
四个尺寸均准确识别“曼谷”,并自动调用get_weather工具完成查询。全程无需额外提示工程。
该能力源自去年底发布的FunctionGemma研究成果,函数调用能力已在训练阶段深度内化,可支撑多轮、多工具协同的Agent工作流——彻底告别过去靠提示词“哄骗”模型调用工具的老路。
Apache 2.0协议,谷歌终于彻底放权
本次发布最大非技术亮点,是Gemma 4首次全面采用Apache 2.0开源协议。
此前Gemma系列采用谷歌自研许可证,内含“禁止有害用途”限制条款及强制署名要求,企业法务需逐条审阅才能确认商用合规性。
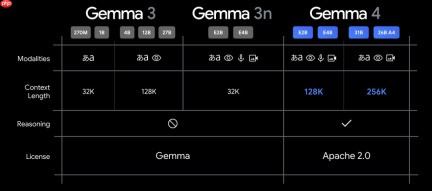
Apache 2.0协议一步到位:无自定义限制、无灰色地带,允许自由修改、分发与商用。
自Gemma初代发布以来,累计下载量突破4亿次,社区衍生模型超10万个。Apache 2.0加持下,这一数字或将加速攀升。
开源游戏规则,已然改写
Gemma 4的登场,标志着谷歌双轨战略全面落地。
上层是Gemini闭源模型矩阵,持续冲击SOTA榜单,通过API服务实现商业变现;下层是Gemma开源生态,以同源技术赋能开发者,抢占本地部署、终端推理与Agent开发入口。
一个负责盈利,一个构建生态。二者互不冲突,反而彼此增强。
对开发者而言,选择前所未有地清晰:
31B模型单卡即跑,效果逼近千亿参数级别;Apache 2.0协议开箱即用;从手机到服务器全栈覆盖;配套微调工具链完备成熟。
参数效率这条赛道,谷歌已率先冲线。31B正面击穿20倍体量对手,2B轻松入驻手机口袋。
开源大模型的竞争格局,正在被彻底重写。
本文来源:新智元



