





Nginx upstream需命名规范、分级容错、强化可观测性:名称用小写短横线体现业务域+功能+版本;必配健康检查与proxy_next_upstream;按SLA分组调度;日志需含$upstream_addr等字段。
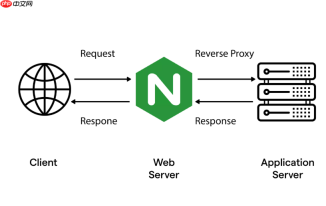
在 Nginx 中合理配置 upstream 块,直接影响服务的稳定性、可观测性和运维效率。命名要清晰可读,容错机制需兼顾可用性与响应质量,不能只写“能用”,而要让故障时有路可退、有据可查。
命名规范:见名知意,层级分明
上游名称不是随便起的别名,它会出现在日志、监控、健康检查和错误信息中,应体现服务语义而非机器细节:
- 用小写字母、数字和短横线(
-),避免下划线或大写,如api-payment-v2而非API_PAYMENT_v2 - 包含业务域+功能+可选版本,不带环境(如
staging),环境应通过不同 server 或 include 区分 - 避免使用 IP 或主机名(如
10-20-30-40或web01),这类命名在扩容或迁移后迅速失效 - 若服务有主备逻辑,可用后缀区分,如
search-primary和search-fallback,但需配合backup指令使用
基础容错:健康检查 + 失败重试必须启用
默认 Nginx 不主动探测后端是否存活,仅靠连接失败被动判断,容易导致请求堆积或雪崩:
- 启用
health_check(需 stream 或 http 模块支持),设置合理间隔与阈值,例如:health_check interval=5 fails=3 passes=2; -
max_fails和fail_timeout必须配对使用,建议设为max_fails=3 fail_timeout=30s,避免单次抖动误判下线 -
proxy_next_upstream至少包含error timeout http_500 http_502 http_503 http_504,允许在异常时转发给其他节点 - 慎用
proxy_next_upstream_tries,一般不超过 2 次,防止长尾放大;搭配proxy_next_upstream_timeout限制总重试耗时
进阶容错:按场景分级处理后端
并非所有后端都该一视同仁。根据 SLA、数据一致性或资源敏感度,可做差异化调度:
- 对强一致写操作,用独立 upstream(如
user-writer),禁用backup和重试,失败直接返回客户端 - 对读服务,可配置多个 upstream 分组(
reader-hot/reader-cold),用split_clients或 Lua 实现灰度路由 - 引入
least_conn或ip_hash时注意副作用:ip_hash在 CDN 后可能失效;least_conn对短连接优势有限,建议结合keepalive使用 - 关键服务建议加
slow_start=30s,新节点上线后逐步增加流量,避免冷启动冲击
可观测性:让 upstream 行为可追踪
出问题时,光看 502 Bad Gateway 没用,要能快速定位是哪个 upstream、哪台机器、因何失败:
- 在
log_format中加入$upstream_addr、$upstream_status、$upstream_response_time,便于分析转发路径 - 用
upstream_info(OpenResty)或自定义变量记录当前选中的 upstream 名,方便关联日志与配置 - 对每个 upstream 块加注释说明用途、负责人、SLA 要求,例如:
# api-order: payment gateway, SLO=99.95%, owner @ops-pay - 定期用
nginx -t验证配置,并将 upstream 列表纳入 CMDB 或服务发现平台同步,避免配置漂移





